「問い合わせの仕分けや議事録の読み取りをAIに任せたいが、1件ごとにお金がかかると聞いて二の足を踏んでいる」「ClaudeもChatGPTも次々に新型が出て、どれを選べばいいのか分からない」。研修先の会社で、この2つの声を本当によく聞きます。
2026年10月7日(米国時間)、Anthropic(Claudeを作っている会社)が、Claudeの小型モデル「Claude Haiku 5.5」を公開しました。Anthropicは、これまでで最も安く、最も速く、最も高性能な小型モデルだと説明しています。値段は前の世代の10分の1、一度に読める量は5倍、そしてHaikuとして初めて「考える深さ」を選べるようになりました。
この記事では、①性能面で何が良くなったのか、②会社の仕事の何ができるようになるのか、③Haiku 4.5から何がどう変わるのか、④ChatGPTと比べてどうなのか、の4つの疑問に順番に答えます。数字は、Anthropicの公式資料と、社内で10月8日の夜に行った実機テストだけを使っています。読者は、ITに詳しくない社長や総務・営業の担当者を想定し、専門の言葉は出るたびに一言で噛み砕きます。
3分で分かる要点
- Haiku 5.5は「速くて安い若手社員」です。仕分け、抜き出し、定型文、長い資料から探す、といった範囲のはっきりした仕事なら、社内テストでは上の兄(Sonnet 5.5)と同じ結果を10分の1以下の費用で出しました
- 料金は100万トークンあたり入力0.10ドル・出力0.50ドルで、Haiku 4.5の10分の1。ただし1回に渡す文章が10万トークン(日本語でおよそ10万字)を超えると、その1回は丸ごと5倍の単価になります
- 変わるのは「AIを1回使う」から「仕組みに組み込んで何千回も回す」への発想です。問い合わせ1,000件の仕分けが約14円なら、任せる仕事の選び方が変わります
- ChatGPTの無料版の中身はGPT-6 Lunaで、Haiku 5.5とAPIの単価がまったく同じ。勝ち負けではなく「同じ値段で性格が違う」関係で、速さと丁寧さのHaiku 5.5、簡潔さと指示への忠実さのLunaです
- 注意点は、10万トークンの境目、考えない設定での数え間違い、もっともらしい誤りがHaiku 4.5と同程度にあること。人が最後に読む前提は変わりません
Claude Haiku 5.5とは——Claudeの4兄弟の中の「速くて安い若手」
結論から言うと、Claude Haiku 5.5は「Claudeの中でいちばん小さく、いちばん安く、いちばん速い」モデルです。それだけ聞くとよく分からないと思うので、会社の人にたとえます。その前に、この記事で繰り返し出てくる5つの言葉を1枚にしておきます。
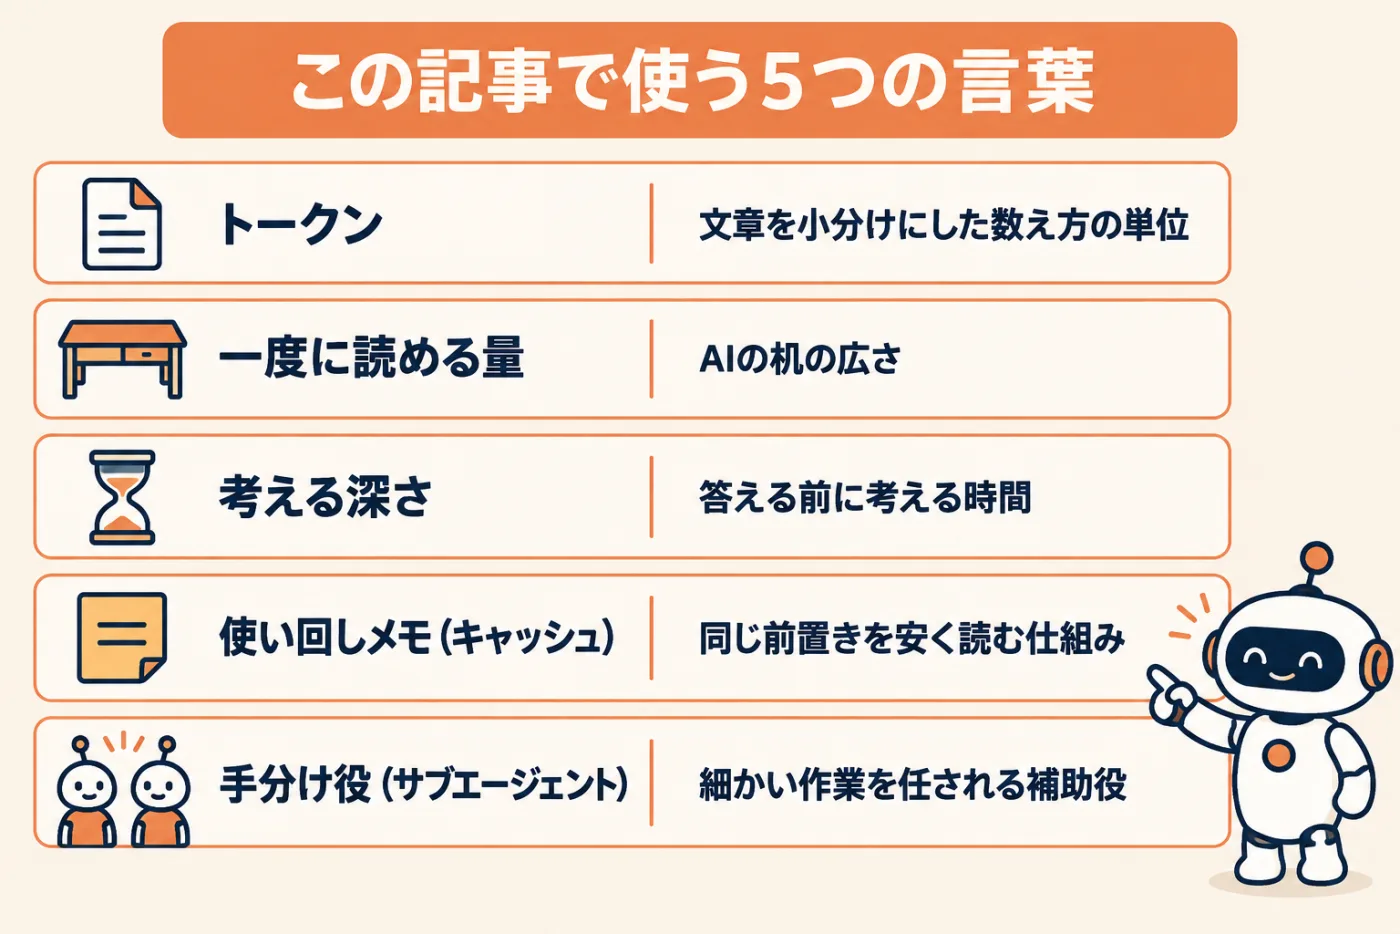
上の図は、専門用語を会社の中の物にたとえた辞典です。分からない言葉が出たら、ここに戻ってください。
Claudeには、2026年10月時点で主に4つのモデルがあります。上からFable、Opus、Sonnet、Haikuで、会社でいえば、難題だけを任せる顧問、何でも任せられる主力のベテラン、幅広くこなす中堅、そして速くて安い若手、という並びです。
| モデル | 会社でいえば | 公式の案内にある向いている仕事 | 入力単価の比(Haiku 5.5を1として) |
|---|---|---|---|
| Fable 5.1 | 難題だけを任せる顧問 | 今回の公式の使い分け案内には出てこない。価格は最上位 | 100 |
| Opus 5.5 | 何でも任せられる主力のベテラン | 複雑な開発や、知識を使う仕事の日常使い | 40 |
| Sonnet 5.5 | 幅広くこなす中堅 | 範囲がはっきり決まった仕事 | 20 |
| Haiku 5.5 | 速くて安い若手 | 速さと量が最優先の仕事 | 1 |
単価の比は、公式の料金表(100万トークンあたりの入力単価)を割り算したものです。若手にたとえたのは、速くて安い反面、難しい判断は上に回すのが前提だからです。Anthropic自身も、Haiku 5.5は要約・分類・仕分け・補助役(サブエージェント)のような範囲のはっきりした作業に向き、複雑な開発の仕事はSonnet 5.5やOpus 5.5が適する、と案内しています。補助役とは、主役のAIが仕事全体を組み立て、細かい調べ物や下準備を若手に振る形のことです。
使える場所も広く、Claudeのアプリでは、Free、Pro、Max、Team、Enterpriseのすべてのプランで、モデルの一覧からHaiku 5.5を選べます(ウェブ、iPhone、Androidとも)。ただし、既定のモデルがHaiku 5.5になったかどうかは、公式ページで確認できていません。開発者向けには、Claude Code(AIにパソコン上の作業を任せる道具)、API(自社の仕組みからAIを呼び出す窓口)、Amazon・Google・Microsoftの各クラウドから使えます。Claude Codeの既定のモデルはOpus 5.5のままです。
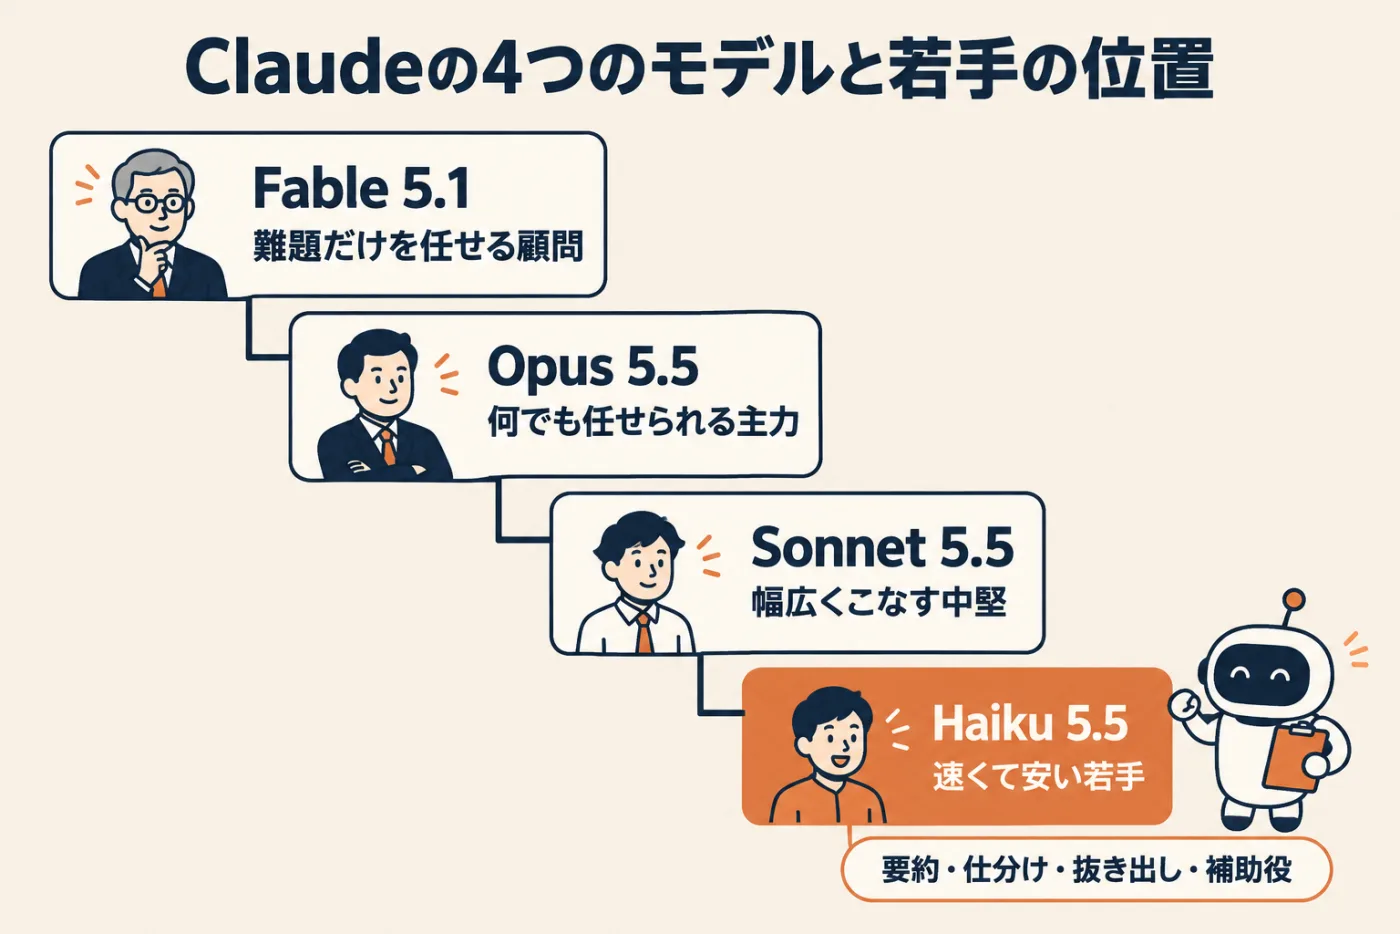
上の図が、この記事の地図です。右下の若手が今回の主役で、以下はこの若手に何を任せられるかを順番に見ていきます。
Haiku 4.5から何が変わったか——7つの変更点
Haiku 5.5の1つ前が、2025年10月に出たHaiku 4.5です。同じ「Haiku」でも中身はかなり変わっていて、変更点は7つに整理できます。
| 項目 | Haiku 4.5 | Haiku 5.5 |
|---|---|---|
| API料金(100万トークンあたり、入力と出力) | 1ドルと5ドル | 0.10ドルと0.50ドル(10万トークン以下のとき) |
| 一度に読める量と書ける量 | 20万トークンと6.4万トークン | 100万トークンと12.8万トークン |
| 考える深さ | 選べない(開発者が思考の予算を手で指定) | 5段階から選べる(既定はmedium) |
| 速さ | 当時、Sonnet 4の2倍超の速さと説明 | 標準速度で同社の過去のどのモデルより速い(Anthropicの説明) |
| ブラウザ操作の道具 | 非対応 | 対応(ウェブページを読んで操作する) |
| 文章の数え方(トークナイザー) | 旧方式 | 新方式。同じ文章が約30%多く数えられる(公式)。日本語だけの文章ではほぼ同じ(社内測定) |
| 安全のための自動の断り | なし | あり |
料金は、入力も出力も10分の1になりました。ただし「10万トークン以下のとき」という条件があり、次の料金の章で詳しく書きます。トークンはAIが文章の量を数える単位で、日本語ではおおむね1文字が1トークン弱です。考える深さ(公式の呼び名はeffort)は、Haiku 5.5が答える前に自分で「どれだけ考えるか」を決める仕組みで、low、medium、high、xhigh、maxの5段階から選べます。既定はmediumで、Claudeのアプリではモデルを選ぶのと同じメニューで深さも選べます。Haikuでこれができるのは初めてです。
速さについて、Anthropicは、各モデルの標準速度で比べて同社の過去のどのモデルよりも速いと説明しています(Opusの高速モードは除く)。公式に「毎秒何文字」という数字はないので、社内で測った数字を後の章に書きます。ブラウザ操作の道具は、AIにウェブページを読ませてクリックや入力をさせる道具で、フォーム入力やアプリ間の情報の移し替えが安いモデルで回せる可能性が出てきました。
文章の数え方は新方式になり、公式は「同じ文章がHaiku 4.5より約30%多くトークンとして数えられる」と説明しています。単価が10分の1になっても、数える量が増えれば割引の幅は縮みます。Anthropicが運用コストの下がり幅を「平均で約75%」と別に示しているのは、この分と10万トークンを超える分を織り込んだ平均だからで、「10分の1」と「約75%」は混ぜないでください。安全のための自動の断りは、サイバー攻撃や生物兵器などに関わる依頼を判定して断る仕組みで、普通の業務で当たることはまずありませんが、同じまま送り直しても通常は同じ結果になります。なお、知っている情報の期限も2025年2月から2026年6月へ新しくなっています。
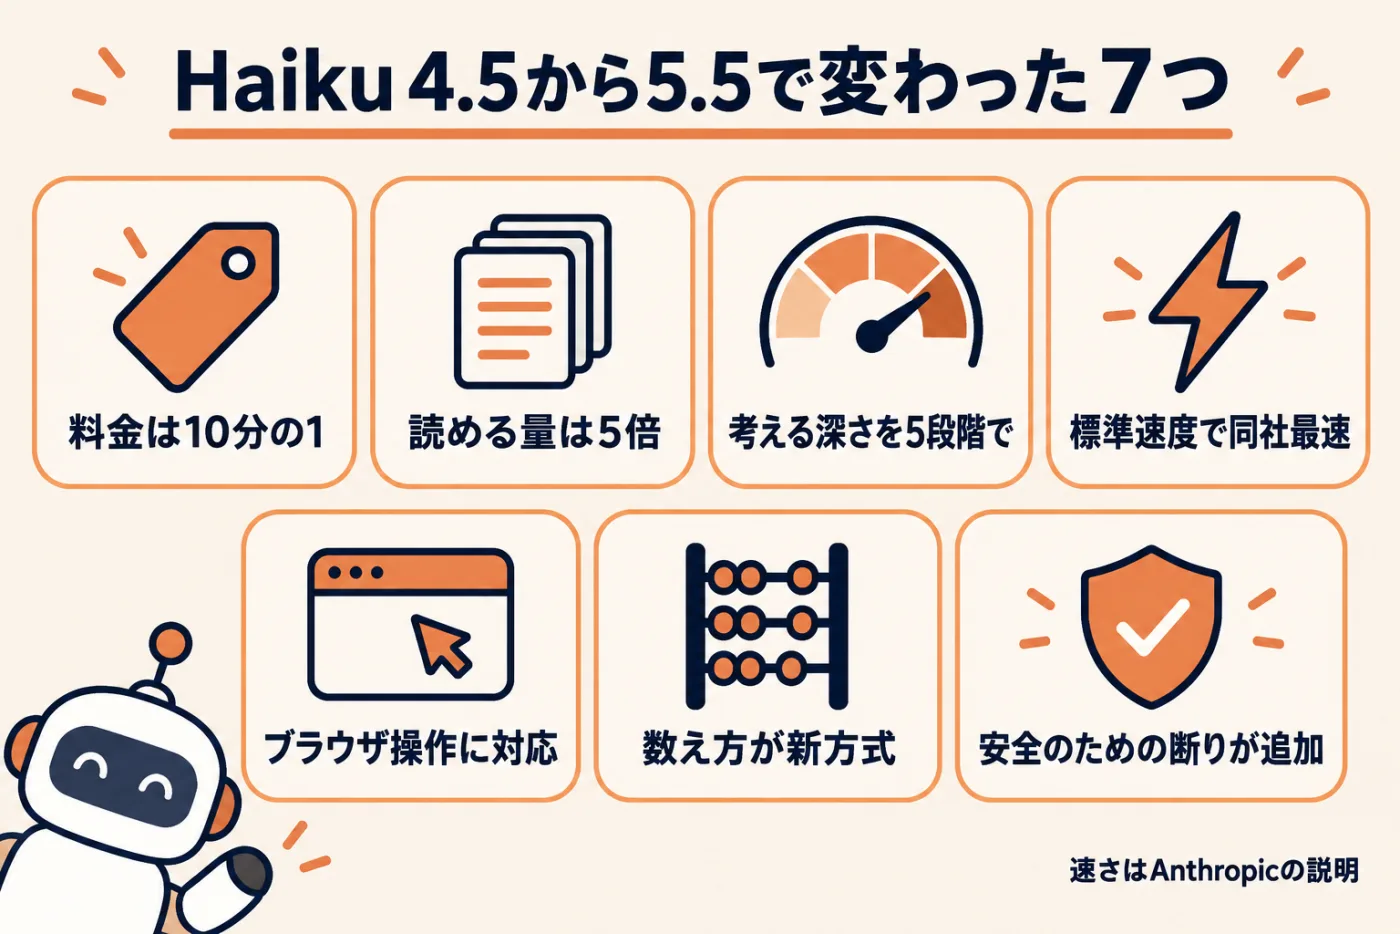
この図は7つの変更点を1枚にしたものです。読者の仕事に直結するのは、上の3つ(料金・量・考える深さ)だと思ってください。
性能面のメリット——公式の数字を「並びの意味」に翻訳する
発表ページには、性能を示すテストの点数が並んでいます。先に2つ、前提を書いておきます。一つは、載っているのはAnthropicが選んだテストで、各社の測り方も違うこと。もう一つは、表の数字が「考える深さを最大(max)にして測った値」であることです。既定のmediumで使うと数字は下がります。なので、点数そのものより「並びの意味」を読むのが正解です。
いちばん分かりやすいのが、人が成果物を見比べて採点する実務テスト(GDPval-AA)です。44の職種の実務を想定した課題で、AIの成果物を人が見比べて点を付けます。
| モデル | 実務テストの点数 | 並びの意味 |
|---|---|---|
| Haiku 4.5 | 735 | 1つ前の世代 |
| GPT-6 Luna | 1437 | 同じ値段帯の他社モデル |
| Haiku 5.5 | 1620 | 今回の主役 |
| Sonnet 5.5 | 1840 | 1つ上の兄 |
翻訳すると、「Haiku 4.5から大きく伸び、同じ値段帯のGPT-6 Lunaより上、1つ上のSonnet 5.5には届かない」です。ただし、これは考える深さを最大にした値で、既定のmediumでは1277に下がり、最大設定で測ったLunaの1437を下回ります。逆を返せば、仕事の難しさに合わせて深さを上げられる余地がある、とも言えます。
パソコン操作のテスト(AIが本物のパソコンを操作して複数の手順の課題をこなす)は72.4%と発表されていますが、これは各課題のチェック項目の達成度を平均した部分点で、全項目を満たした厳密な合格は37.1%です。Haiku 4.5は部分点で15.7%だったので伸び幅は大きいのですが、「7割の課題を最後までやり切る」という意味ではありません。
一方で、はっきり差が残る領域もあります。コマンド操作で複雑な開発を進めるテストでは、Haiku 5.5が39.2%、Sonnet 5.5が70.6%で、Anthropicが「複雑な開発の仕事はSonnet 5.5・Opus 5.5へ」と案内しているのはこのためです。安全性の報告書(システムカード)の総括も、Haiku 4.5を多くの領域で大きく上回り、一部ではSonnet 5.5と同等かそれ以上だが、多くの評価ではSonnet 5.5の水準に届かなかった、という書き方です。
考える深さと点数の関係
深さを上げるほど正確になる代わりに、時間と費用が増えます。公式の目安は、lowが会話や単純な大量処理、既定のmediumが多くの仕事の出発点、highが知識を使う仕事や指示を厳密に守らせたいとき、xhighとmaxは品質が費用に見合うと自社で確かめたときだけ、です。安全性の報告書によると、実務テストで既定のmediumが使った出力トークン(書いた量と考えた量)は、最大のときの約10分の1でした。基本的にはmediumで始めて、間違いが出る仕事だけ上げるのが現実的かなと思います。
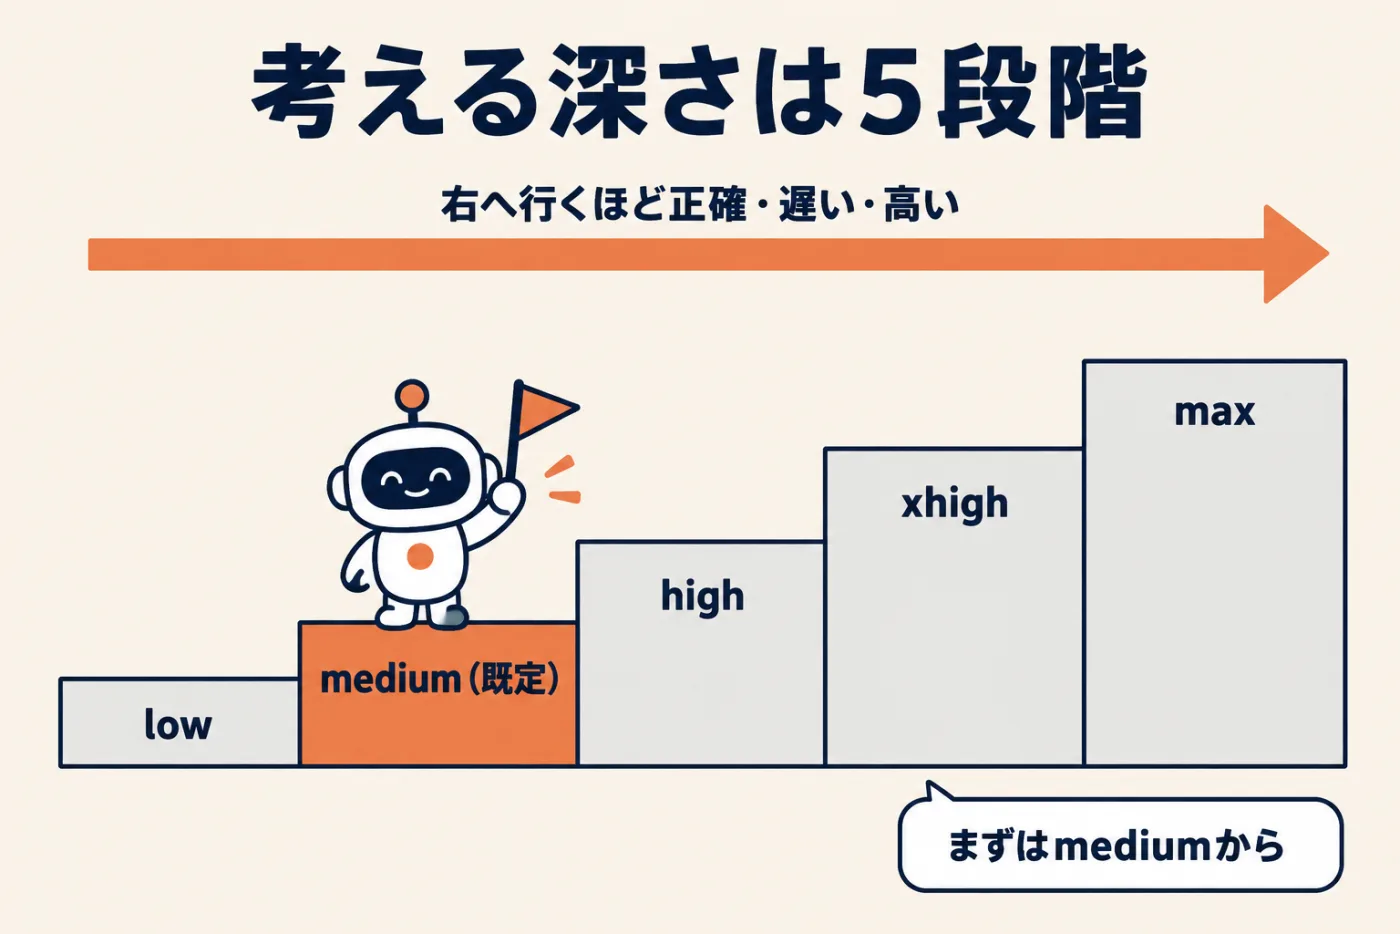
この図は、深さの5段階を階段で表したものです。右へ行くほど賢く、重く、高くなる、と見てください。
使っている会社の声
発表ページには、先行して試した会社のコメントが載っています(いずれも各社の自社測定)。
| 会社 | 測った仕事 | 結果 |
|---|---|---|
| Box(文書管理) | 初期テストの正確さと待ち時間 | Haiku 4.5より11ポイント高く、待ち時間は約半分 |
| Asana(仕事の管理ツール) | AIの担当者が案件を仕分け・整理する仕事 | 完了までの待ち時間が30%超減、1手あたり最大2.5倍速い |
| HubSpot(営業・顧客管理) | 模擬環境での顧客管理の業務 | 小型モデルとしては最高の92.8% |
| AlphaSense(金融の調査) | 文書への質問に答える機能 | 正確さの指標が0.76から0.84へ |
共通するのは「安く速く、たくさん回す仕事で前より正確になった」という評価で、後半の社内テストも同じ方向の結果でした。
料金を円で見る——100万トークンって何文字?
ここからは費用の話です。前提は3つ。公式の料金表は米ドル表示なので1ドル150円の仮定で円に直すこと、消費税や為替の変動は含まないこと、そして「100万トークン」は日本語では「おおむね100万字」と読み替えてよいこと(社内の実測で日本語1文字が約0.97トークン)です。
単価の表
| モデル | 入力(100万トークンあたり) | 出力(100万トークンあたり) |
|---|---|---|
| Haiku 5.5(10万トークン以下のとき) | 0.10ドル(約15円) | 0.50ドル(約75円) |
| Haiku 5.5(10万トークン超のとき) | 0.50ドル(約75円) | 2.50ドル(約375円) |
| Haiku 4.5 | 1ドル(約150円) | 5ドル(約750円) |
| Sonnet 5.5 | 2ドル(約300円) | 10ドル(約1,500円) |
| Opus 5.5 | 4ドル(約600円) | 20ドル(約3,000円) |
入力は「AIに読ませる量」、出力は「AIが書く量」です。日本語の資料を10万字ずつに分けて合計100万字読ませても約15円、100万字書かせても約75円という単価で、Haiku 4.5の10分の1、Sonnet 5.5の20分の1、Opus 5.5の40分の1です。
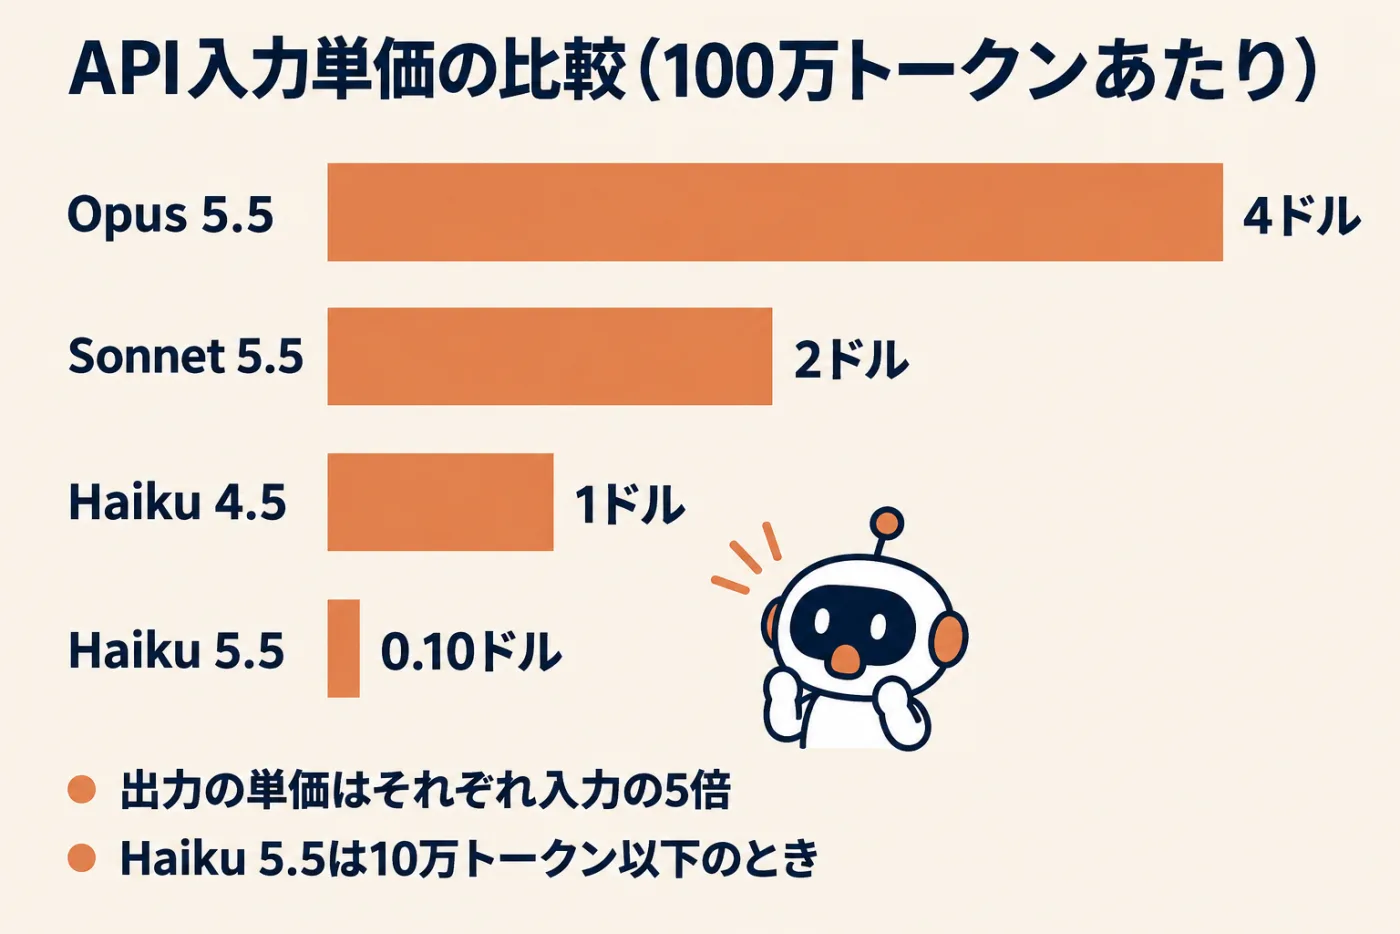
この図は、4つのモデルの単価を棒の長さで並べたものです。Haiku 5.5の棒がほとんど見えない、というのが今回の値下げの大きさです。
10万トークンの境目
Haiku 5.5の料金には、ほかのモデルにはない「境目」があります。1回の依頼で読ませる量(プロンプト)が10万トークンを超えると、超えた分だけではなく、その1回の入力も出力も丸ごと5倍の単価になります。Anthropicは、前世代のHaikuへの依頼の約90%は10万トークン以下だったので、ほとんどの用途は安い方の単価で収まる、と説明しています。
日本語に直すと、境目は「1回におよそ10万字まで」です。基本的には境目の内側で使い、超えそうなら資料を分けるか、後で出てくる使い分けの表でSonnet 5.5と比べる、という考え方です。
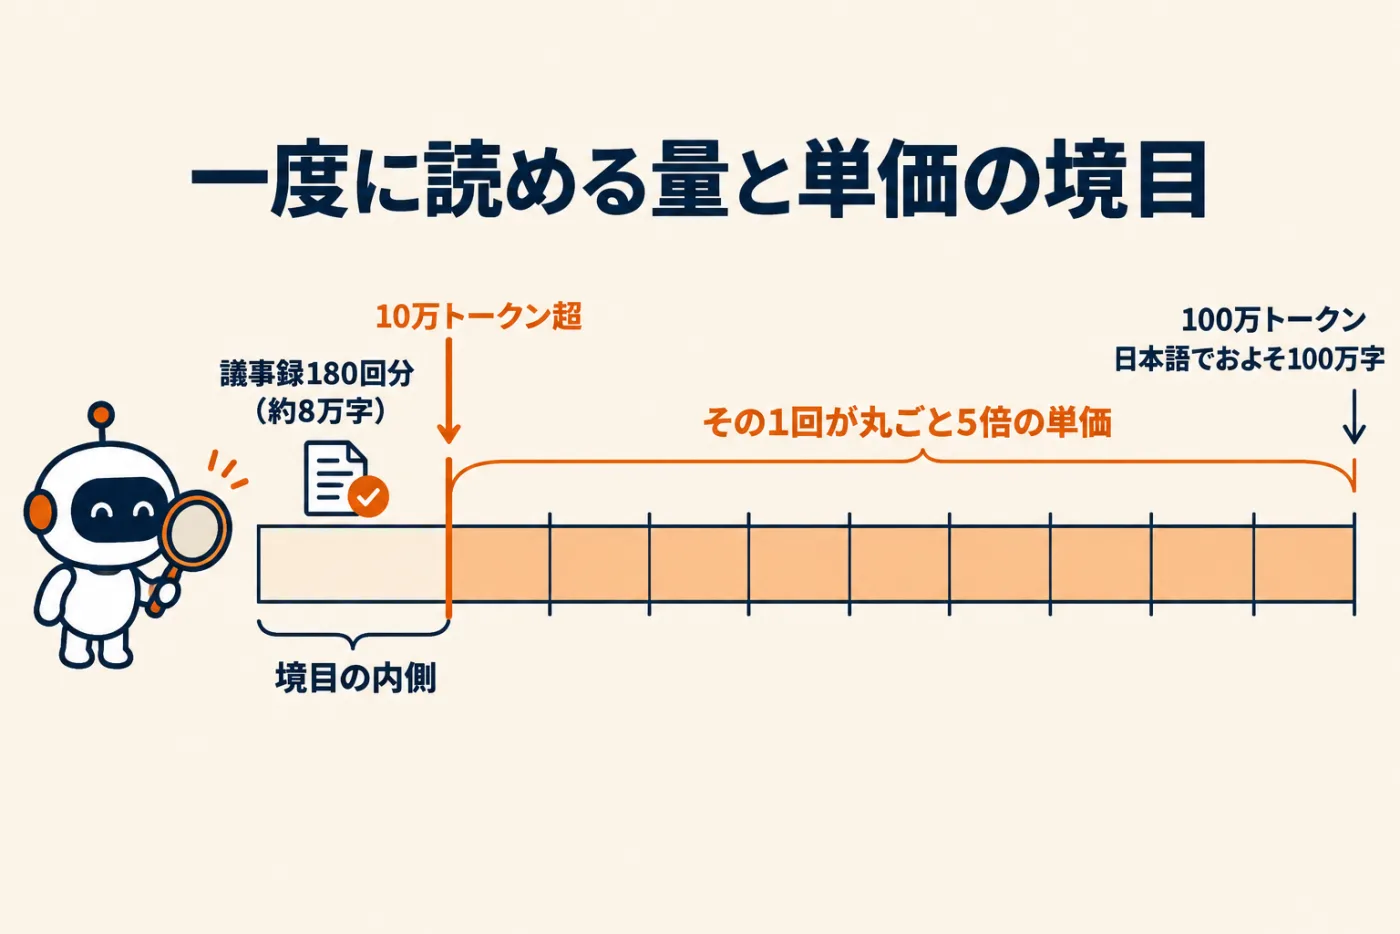
この図は、読める量の全体と、単価が変わる境目の位置を示したものです。社内テストで使った週次の営業会議の議事録は、境目の内側に収まっています。
さらに安くする2つの仕組み
| 仕組み | どんなときに効くか | 単価(10万トークン以下のとき) |
|---|---|---|
| 同じ前置きの使い回し(プロンプトキャッシュ) | 社内ルールや商品一覧など、毎回同じ文章を先頭に付けて送るとき | 読み取りは入力の10分の1(100万トークンあたり0.01ドル) |
| まとめて処理(Batch) | 急がない大量処理を、まとめて後で受け取ってよいとき | 入力も出力も半額(0.05ドルと0.25ドル) |
業務別の月額の目安(円)
単価の表だけでは実感が湧かないので、次の章の社内テストで実際にかかった1件あたりの費用に、中小企業でよくある月の件数を掛けて、月額の目安を先に出しておきます。前提は、1ドル150円、考える深さは既定、1回の依頼は10万トークン以下、前置きの使い回しなし。件数は「例えば」の仮定で、口コミの分類は仕分けと同じ型の作業と仮定しています。
| 業務(月の量の例) | Haiku 5.5の月額の目安 | 計算の元 |
|---|---|---|
| 問い合わせの仕分け 300件 | 約4円 | 1件約0.014円 |
| 問い合わせからの情報の抜き出し 500件 | 約10円 | 1件約0.0208円 |
| 約8万字の議事録20本に質問1回ずつ | 約25円 | 1回約1.23円 |
| 口コミ・アンケートの分類 1,000件 | 約14円 | 仕分けと同じ型と仮定 |
| お詫び・案内の下書き 100通(400字前後) | 約3円 | 1通約0.027円 |
5つを全部やっても、月に合計で約56円です。費用の問題はもうなく、「誰がどの仕事を任せると決め、誰が最後に確認するか」という段取りの問題だと分かります。なお、次の章の表でHaiku 4.5との差が単価の「10分の1」より小さい行があるのは、Haiku 5.5が既定の設定で「考える」分のトークンを使うからです。深さを上げる仕事や10万トークンを超える資料を渡す仕事では、桁が変わります。
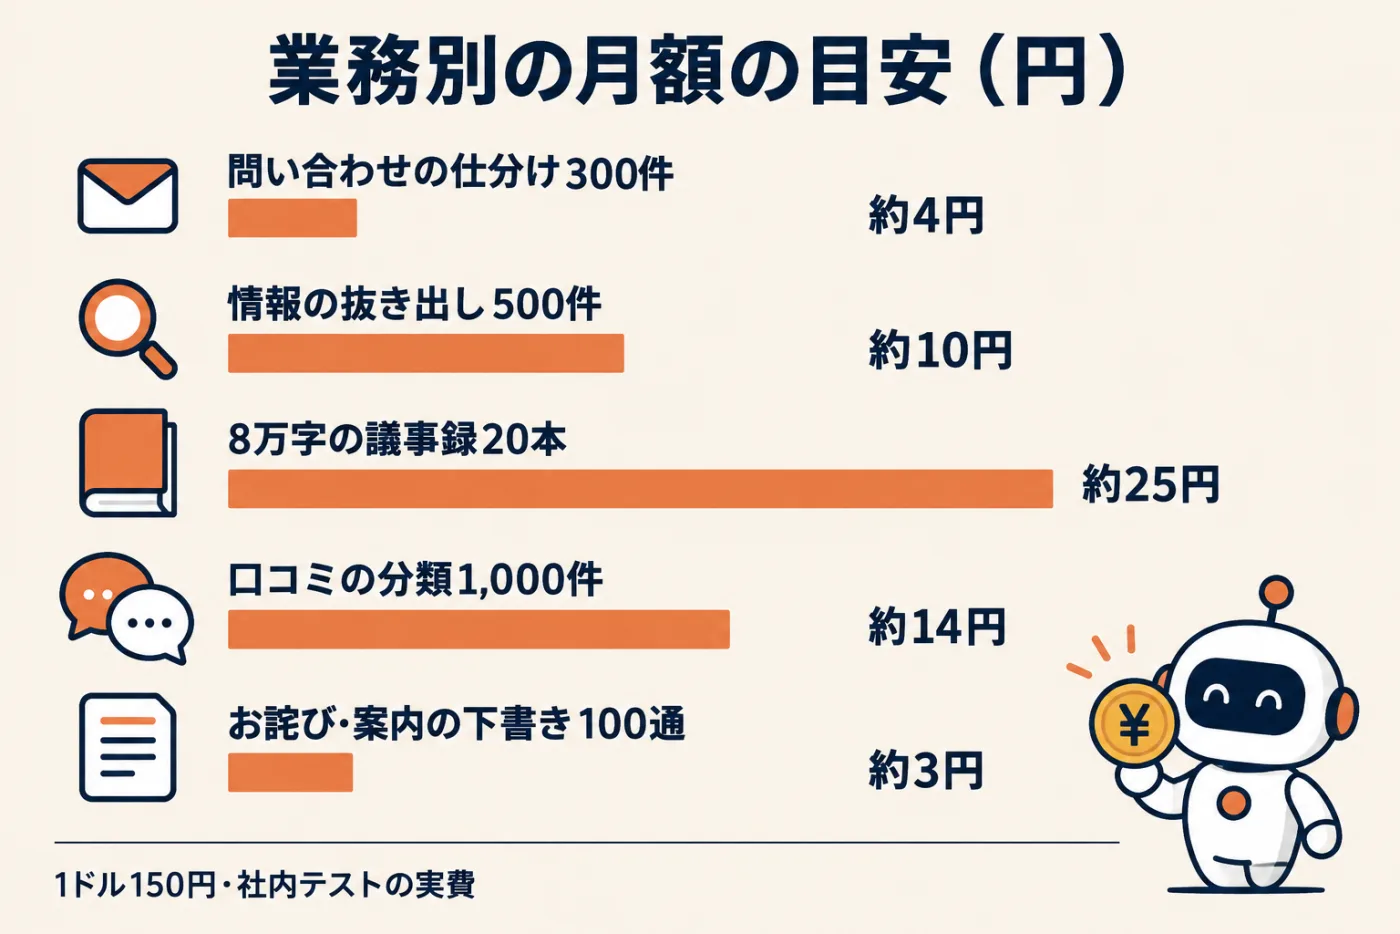
この図は、上の表を1枚にしたものです。月の件数が10倍になっても、桁がひとつ上がるだけです。
同じ日に発表された、ついでの2つ
同じ日に、Sonnet 5.5の「同じ前置きの使い回し」の読み取り単価が半額(100万トークンあたり0.20ドルから0.10ドル)になり、ClaudeのMaxプランとTeamプランに毎月のAPI用クレジット(Max 5xは月100ドル、Max 20xは月200ドル、Teamは合算で最大500ドル)が付きました。後者は、アプリの契約だけで自社の仕組みにAIを組み込む試作が始められる、という意味で中小企業には見逃せない変更です。
WizTryの実機テスト——5種類の仕事で確かめた
ここからが、この記事の中心です。公式の数字は英語のテストが中心なので、「熊本の中小企業の日本語の仕事」で確かめました。先に条件を書きます。
- 実施は2026年10月8日の夜(日本時間)、熊本の社内のMacから
- 経路はOpenRouter(複数社のAIを1つの窓口で呼べるサービス)。各モデルとも開発元の自社サーバーに固定。速さには日本からの通信時間が含まれます
- 問題はすべて、架空の熊本のリフォーム会社「ひのくにリフォーム」を想定して社内で作成。実在の人物・会社とは関係ありません
- 円換算は1ドル150円の仮定。料金はOpenRouterの請求額で、各社の定価と同額。消費税・為替は含みません
- 小さな社内テストで、性能の順位を決める試験ではありません。回数は、仕分け30件、抜き出し10件、文章3題×2回、長い資料3回(Haiku 4.5は2回、Sonnet 5.5は1回)、速さ5回
比べたのは、次の6通りの設定です。
| 設定 | 意味 |
|---|---|
| Haiku 5.5(標準) | 何も指定しない状態。必要に応じて「考えてから答える」 |
| Haiku 5.5(考えない設定) | 考える機能をオフにした状態(APIでだけ選べる) |
| Haiku 4.5 | 1つ前の世代。考える機能は既定でオフ |
| GPT-6 Luna(標準) | OpenAIの、Haiku 5.5と同じ値段帯のモデル。何も指定しない状態(既定で少し考える) |
| GPT-6 Luna(考えない設定) | 考える強さを「none」にした状態 |
| Sonnet 5.5(標準) | Claudeの1つ上のモデル(参考) |
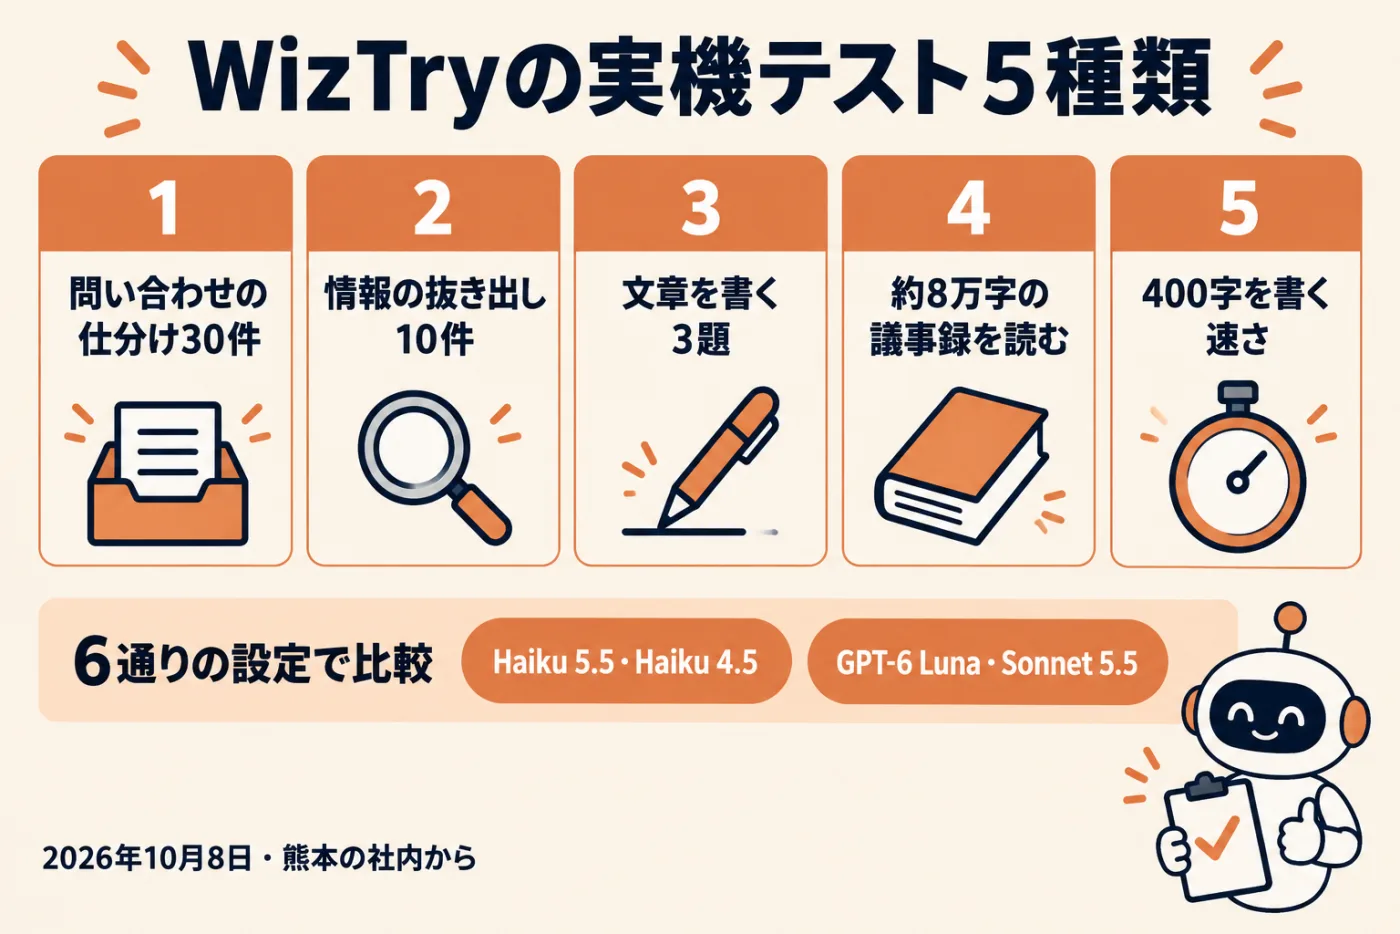
この図は、5つのテストで何を測ったかの一覧です。上から順に、量の多い定型作業、文章、長い資料、速さ、という並びです。
テスト1 問い合わせの仕分け(30件・8分類)
リフォーム会社に届く問い合わせ30件を、見積依頼、日程変更・キャンセル、苦情・不具合、請求・支払い、採用、営業・売り込み、要注意(詐欺の疑い)、その他の8つに仕分けさせました。熊本弁、英語、遠回しなキャンセル、振込先変更の詐欺、社長のなりすまし、偽のログイン通知を混ぜています。判断が分かれる3件は別解も正解にしました。出力は「JSON(プログラムで読める決まった形)だけ、理由は30字以内」と指示しています。
| 設定 | 正解 | 1件の時間(中央値) | 1,000件の費用 |
|---|---|---|---|
| Haiku 5.5(標準) | 30件中30件 | 1.63秒 | 約14円 |
| Haiku 5.5(考えない設定) | 30件中30件 | 1.31秒 | 約7円 |
| Haiku 4.5 | 30件中29件 | 1.14秒 | 約73円 |
| GPT-6 Luna(標準) | 30件中29件 | 2.46秒 | 約7円 |
| GPT-6 Luna(考えない設定) | 30件中28件 | 1.36秒 | 約5円 |
| Sonnet 5.5(標準) | 30件中30件 | 1.54秒 | 約190円 |
分かったことは3つです。一点目、熊本弁(「雨漏りのしよるけん、屋根ば一回見に来てもらえんですか」)は全設定が「見積依頼」と正解し、詐欺の3件(振込先口座の変更、社長なりすましの至急送金、偽のパスワード再設定)も全設定が「要注意」と正解しました。
二点目、外れたのは判断が割れる文です。「補助金を使うので見積書と請求書の日付を分けてほしい」(正解は「請求・支払い」)を、Luna(標準)は「要注意」、Haiku 4.5とLuna(考えない設定)は「見積依頼」としました。Luna(考えない設定)は「今回は見送ることにしました」という遠回しなキャンセルを「その他」にしています。
三点目は、仕組みに組み込むときに効く差です。「JSONだけで返す」という指示を、Haiku 4.5は30件すべてで守れず囲み記号つきで返しました(プログラムで読むには一手間要ります)。Haiku 5.5(標準)は3件だけ囲みが付き、Lunaは30件とも指示どおりでした。また、同じ単価のHaiku 5.5(標準)とLuna(標準)で費用に2倍の差が出たのは、1件あたりHaiku 5.5が平均約93トークン、Lunaが約28トークン「考えた」からです。単価が同じでも、考える量で費用が変わります。
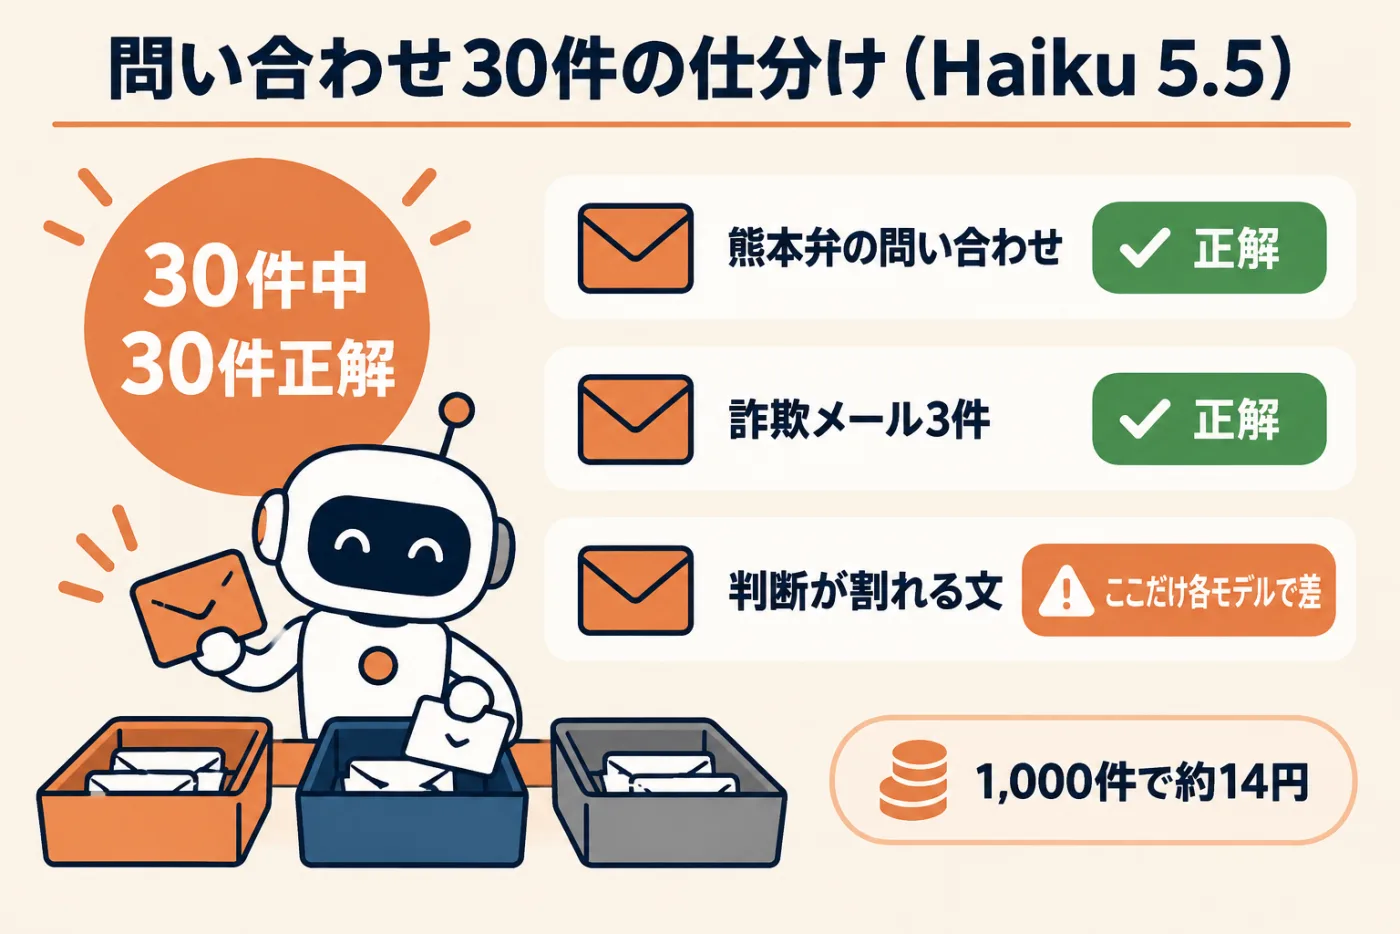
この図は、仕分けテストで何が正解で何が外れたかを示したものです。方言と詐欺の行に注目してください。
テスト2 問い合わせ文からの情報の抜き出し(10件×6項目)
問い合わせ文から、会社名、担当者の名字、希望日、人数、電話番号、予算の合計の6項目を抜き出させました(10件で60か所)。全角数字、和暦、「来週の火曜日」「11月の第2水曜日」のような日付(今日は2026年10月8日の木曜だと伝えて西暦に直す)、漢数字、「1人あたり2万円×8人」の掛け算、転送メールでの依頼主の取り違え、電話番号のない文、を含めています。
| 設定 | 正解 | 1件の時間(中央値) | 1,000件の費用 |
|---|---|---|---|
| Haiku 5.5(標準) | 60か所中60 | 1.76秒 | 約21円 |
| Haiku 5.5(考えない設定) | 60か所中59 | 1.26秒 | 約9円 |
| Haiku 4.5 | 60か所中60 | 1.12秒 | 約102円 |
| GPT-6 Luna(標準) | 60か所中59 | 2.42秒 | 約12円 |
| GPT-6 Luna(考えない設定) | 60か所中60 | 1.61秒 | 約7円 |
| Sonnet 5.5(標準) | 60か所中60 | 3.02秒 | 約326円 |
日付の計算(来週の火曜は10月13日、再来週の金曜は10月23日、11月の第2水曜は11月11日、年明けの1月15日は2027年)は、全設定が全問正解でした。外れたのは2つの設定とも同じ1か所で、「(株)天草マリン」を「天草マリン」と、「株式会社」を落として返したものです。このテストは差がほとんど出ませんでした。定型の抜き出しなら、どれを使っても実用水準、というのが今回の結果です。なので、抜き出しの仕事で選ぶなら、正解率ではなく費用と速さで選んでよいと思います。
テスト3 文章を書く(3題×2回)
①お詫びメール(宛先・理由・新しい開始日・差出人を指定、件名込み300字以内、絵文字なし)、②大工の求人キャッチコピー5案(各20字以内、番号付き、前置き不要)、③LINEの研修案内(200字以内、日時・無料・返信で申し込みを必ず入れる)の3題を、各2回ずつ書かせました。字数や必須の言葉といった機械で数えられる条件は、Haiku 4.5の1回(308字で超過)以外すべて満たしたので、「そのまま貼って使えるか」を目視で判定しました。基準は、頼んでいない事実を足していない、記号が混ざっていない、前置き・後書きがない、日本語の誤りがない、の4つです。
| 設定 | そのまま使えた | 気になった点 |
|---|---|---|
| Haiku 5.5(標準) | 6回中5回 | キャッチコピーの1案が「腕one本で、家を建てる誇り」と、日本語の中に英単語が混ざった |
| Haiku 5.5(考えない設定) | 6回中5回 | LINE文の前後に「以下、LINEで送る研修案内文です」のような前置き・後書きと区切り線が付いた |
| Haiku 4.5 | 6回中2回 | お詫びメールに頼んでいない曜日を足し、しかも誤り。記号の混入、頼んでいない内容の追加も |
| GPT-6 Luna(標準) | 6回中6回 | なし(最も短く簡潔。LINE文は58字) |
| GPT-6 Luna(考えない設定) | 6回中6回 | なし |
| Sonnet 5.5(標準) | 6回中3回 | 「(約120字)」のような後書き。お詫びメールに「手配の管理を徹底いたします」という約束を自分で足した |
Haiku 5.5(標準)が書いたお詫びメールは、次のとおりです(216字)。
件名:キッチン工事開始日変更のお詫び
高橋様
いつもお世話になっております。ひのくにリフォームの末松でございます。 このたびは、資材の入荷遅れにより、キッチン工事の開始日を10月17日から10月20日へ変更させていただくこととなりました。ご予定の調整にご迷惑をおかけすることとなり、誠に申し訳ございません。 ご不明な点やご都合の合わない点がございましたら、お気軽にお知らせください。今後ともよろしくお願い申し上げます。
ひのくにリフォーム 末松
宛先、理由、新しい日付、差出人が指示どおりで、余計な約束も足していません。一方、Haiku 4.5は「10月17日(月)」のように頼んでいない曜日を足し、しかも実際は土曜で誤っていました。Sonnet 5.5の後書きは会話の相手としては親切ですが、自動で送る仕組みに組み込むと後書きごと送られてしまいます。教訓は、自動で送るなら指示に「本文だけを出力。前置き・後書き・記号は付けない」と書くこと。そして、人が最後に読む前提は変わらないことです。
テスト4 長い資料の読み取り(議事録180回分・約8万字)
架空の会社の「週次営業会議」の議事録180回分(80,929字)を一度に渡し、3問に答えさせました。問1は「第119回の『くまもと住まいフェア2026』の費用は?」(正解38万円。前年版の22万円がひっかけ)、問2は「『阿蘇ファーム』が初めて議題に上がったのは第何回?」(正解56回。99回と148回にも登場)、問3は「全期間で『決定:保留』になった議題はいくつ?」(正解7。資料全体を数える必要がある)です。
| 設定 | 問1と問2(探す) | 問3(数える) | 1回の費用 |
|---|---|---|---|
| Haiku 5.5(標準) | 3回とも正解 | 3回中3回正解 | 約1.2円 |
| Haiku 5.5(考えない設定) | 3回とも正解 | 3回中1回(8、8、7と答えた) | 約1.2円 |
| Haiku 4.5(2回) | 2回とも正解 | 2回中0回(5、4) | 約11.9円 |
| GPT-6 Luna(標準) | 3回とも正解 | 3回中3回正解 | 1回目 約1.3円、2回目以降 約0.12円 |
| GPT-6 Luna(考えない設定) | 3回とも正解 | 3回中0回(4、5、5) | 1回目 約1.3円、2回目以降 約0.11円 |
| Sonnet 5.5(標準、1回) | 正解 | 1回中1回正解 | 約24.1円 |
結果ははっきりしていました。探す問題(問1・問2)は全設定が正解。数える問題(問3)は「考える」設定だけが安定して正解し、考えない設定はClaudeでもLunaでも数え間違えました。時間の中央値は、Haiku 5.5(標準)が4.6秒、考えない設定が1.7秒、Luna(標準)が3.5秒、Sonnet 5.5が6.0秒です。8万字を読ませて1回約1.2円という費用も見てください(Haiku 4.5は約11.9円、Sonnet 5.5は約24.1円)。Lunaの2回目以降が約10分の1になったのは、OpenAI側で同じ資料の読み込みを自動で使い回す仕組み(プロンプトキャッシュ)が効いたためです。Claudeにも同じ仕組みはありますが、使うには指定が必要で、今回は同じ条件にするため指定していません。また、同じ80,929字がClaudeでは78,855トークン、Lunaでは69,425トークンと数えられ、同じ日本語でもLunaの方が約1割少なく数えます。
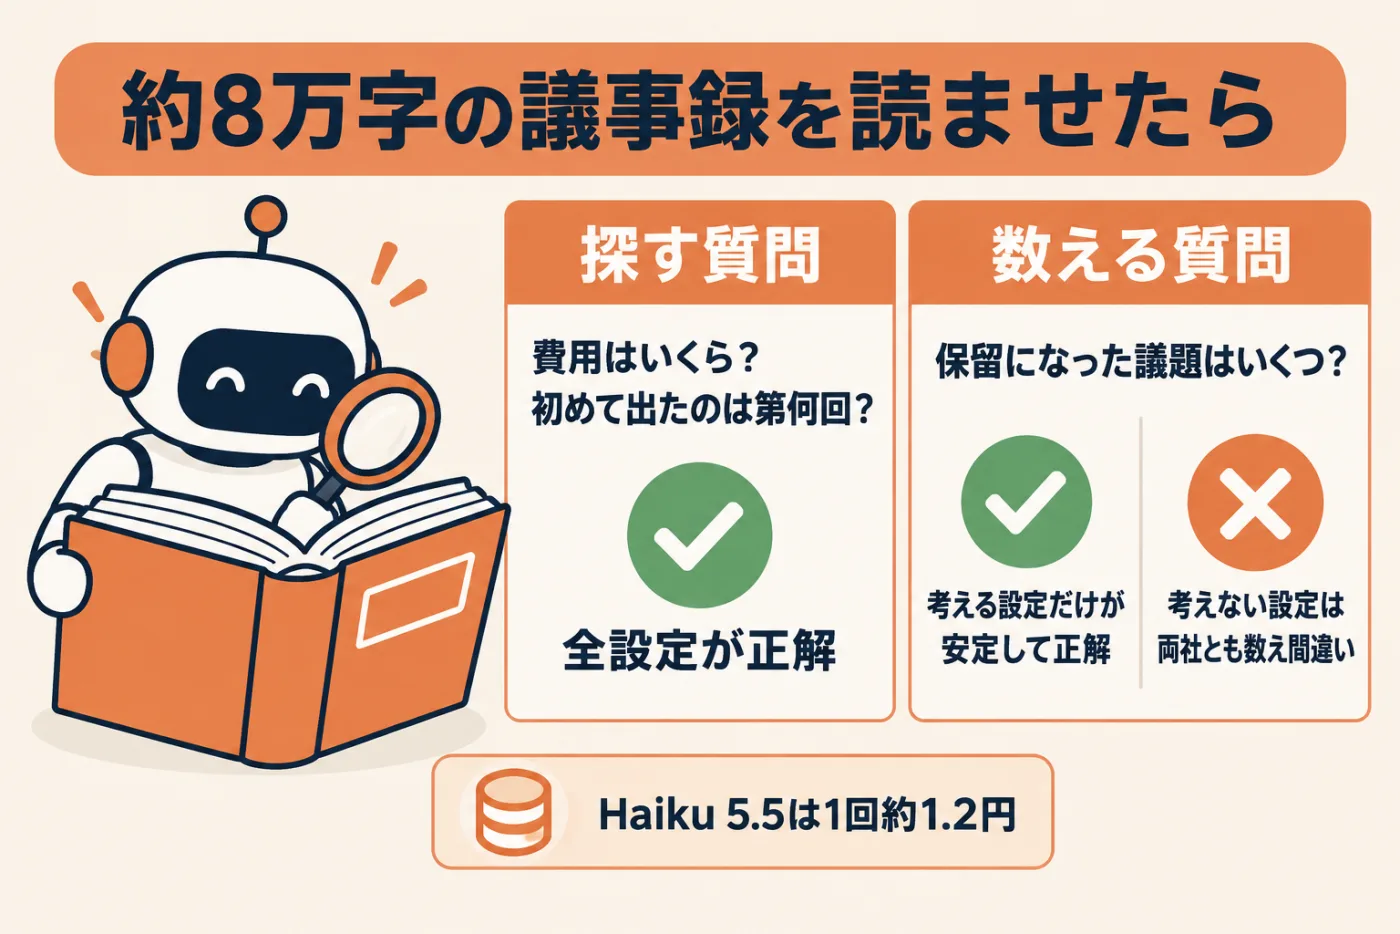
この図は、長い資料に対する「探す」と「数える」の違いを示したものです。数える仕事を任せるときは、考える設定を切らないでください。
テスト5 速さ(約400字の説明文・5回の中央値)
「中小企業の社長向けに、AIを仕事に取り入れるときの注意点を400字程度で」と頼み、最初の文字が出るまでと、書き終わるまでの時間を5回測りました。
| 設定 | 最初の文字が出るまで | 書き終わるまで | 1,000回の費用 |
|---|---|---|---|
| Haiku 5.5(標準) | 1.18秒 | 2.92秒 | 約27円 |
| Haiku 5.5(考えない設定) | 0.88秒 | 3.04秒 | 約29円 |
| Haiku 4.5 | 0.83秒 | 4.14秒 | 約293円 |
| GPT-6 Luna(標準) | 3.04秒 | 4.74秒 | 約36円 |
| GPT-6 Luna(考えない設定) | 1.08秒 | 4.25秒 | 約22円 |
| Sonnet 5.5(標準) | 6.30秒 | 6.32秒 | 約1,193円 |
書き終わるまでが最も短かったのはHaiku 5.5で、書き出してからの速さは毎秒約200字と、Haiku 4.5(毎秒約130字)の約1.5倍でした。Luna(標準)は書き出す前に考える時間が約3秒あり、最初の文字が出るまでが長くなっています。Sonnet 5.5(標準)は約400トークン考えてから一度に返したので、最初の文字と書き終わりがほぼ同時でした。通信の混み具合で数字は変わるので、同じ日の同じ時間帯に1本ずつ順番に測っています。
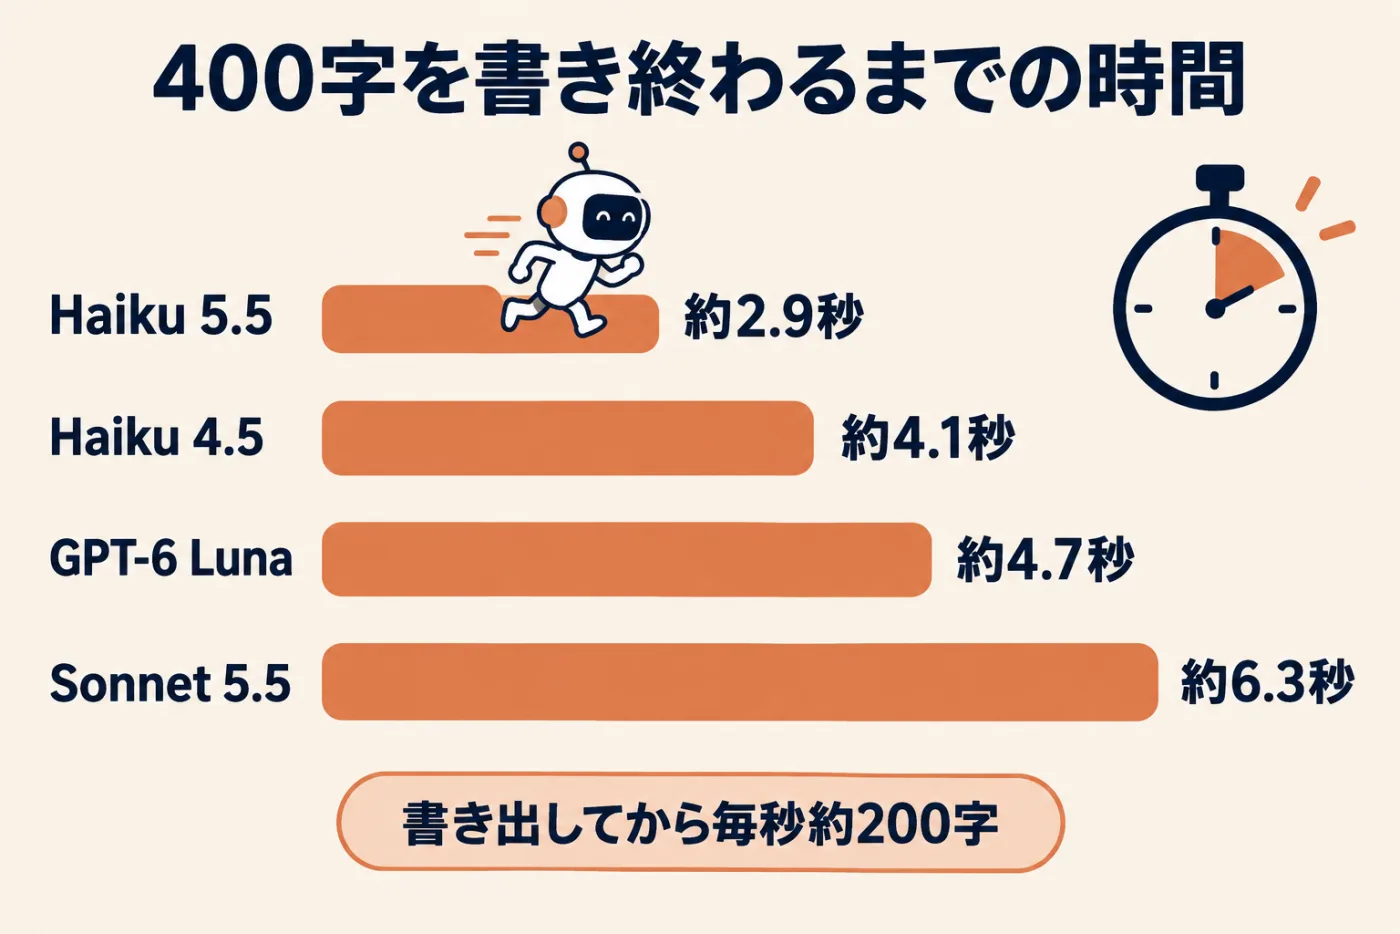
この図は、書き終わるまでの時間を横棒で並べたものです。人が待つ場面(チャット窓口、電話応対の補助)では、この差が体感として出ます。
日本語の「数え方」の実測
公式資料は「同じ文章を約30%多く数える」と説明しています。英語中心の説明なので、社内で文章の種類を変えて同じ文章を送り、請求の元になる入力トークンを比べました(各4,400〜6,000字)。
| 文章の種類 | Haiku 5.5 | Haiku 4.5 | GPT-6 Luna |
|---|---|---|---|
| 日本語の議事録(ほぼ日本語だけ) | 5,813 | 5,810 | 5,059 |
| 数字と表の多い見積書 | 3,872 | 3,804 | 3,132 |
| カタカナ・英字まじりの業務メール | 3,418 | 3,135 | 2,461 |
| プログラム(日本語のコメント付き) | 3,124 | 2,658 | 1,902 |
| 英語の文章 | 1,818 | 1,094 | 1,012 |
Haiku 4.5と比べた増え方は、日本語だけの議事録ではほぼ同じ、英字やプログラムが多い文章ほど増え、英語がいちばん増えました。公式の「約30%増」は英字やプログラムが多い文章ほど当てはまり、日本語だけの文章ではほとんど増えません。日本語の業務文書を中心に使う会社では、単価の10分の1がほぼそのまま効く、と読んでいます(Sonnet 5.5の数え方はHaiku 5.5と同じ)。一方で、同じ文章をGPT-6 Lunaより15〜80%多く数える面もあります(日本語だけで約15%、英字まじりで約40%、英語で約80%)。単価は同じでも、読ませる量が同じなら入力の費用はHaiku 5.5の方が高くなります。目安として、日本語1文字はClaudeで約0.97トークン、Lunaで約0.86トークン。Claudeの「10万トークン」は日本語でおよそ10万字(今回の数え方で約10万3千字)です。
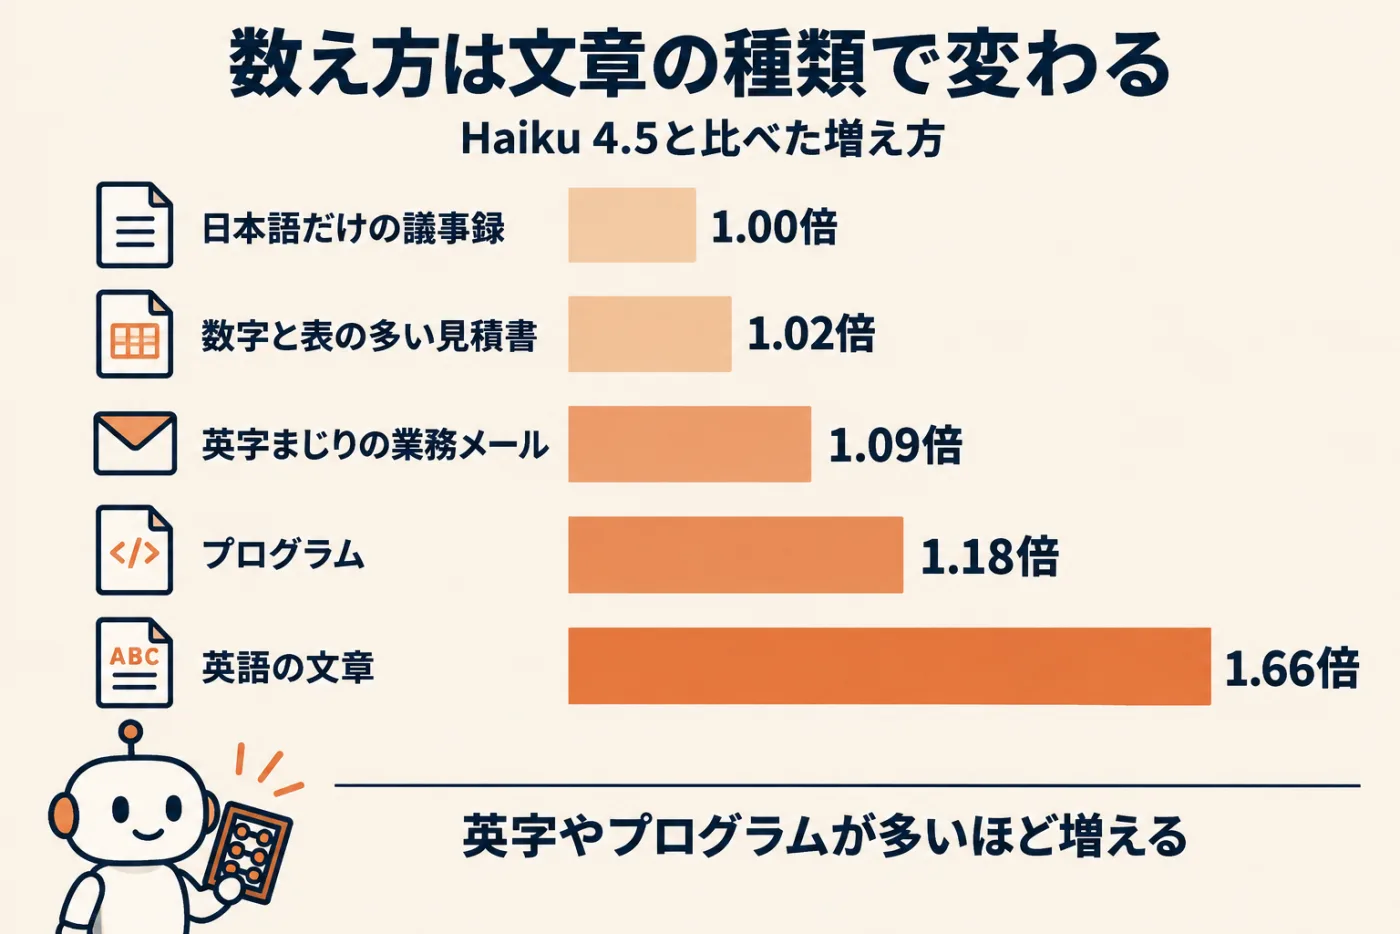
この図は、文章の種類ごとの増え方を並べたものです。自社の文書がどの段に近いかで、割引の効き方が読めます。
テストから分かった使い方のコツ
5つのテストをまとめると、使い方のコツは次の5つです。
| 場面 | おすすめの設定 | 理由 |
|---|---|---|
| 仕分け・抜き出しなど定型の作業 | 既定のまま(APIなら考えない設定で費用は約半分) | 正解の数は考えない設定でもほぼ同じだった |
| 数える・集計する | 考える設定(既定のまま) | 考えない設定は、ClaudeでもLunaでも数え間違えた |
| 自動で送る文章 | 「本文だけを出力。前置き・後書き・記号は付けない」と指示 | 後書きや記号が混ざると、そのまま送られてしまう |
| 長い資料 | 1回10万トークン(約10万字)以内。同じ資料を何度も使うなら前置きの使い回しを指定 | 10万トークンを超えると単価が5倍。使い回しの読み取りは10分の1 |
| 人が待つ場面 | Haiku 5.5の標準で十分 | 400字を約2.9秒で書き終えた |
ちなみに、この記事のテスト全体(試し打ちを含めて約350回)の費用は約0.7ドル、1ドル150円で約105円でした。その約85%は比較用のHaiku 4.5とSonnet 5.5の分で、Haiku 5.5は約9円、GPT-6 Lunaは約4円です。試す費用は、もう理由になりません。
何ができるようになるか——中小企業の使い道10選
ここまでで、Haiku 5.5は「定型の仕事を、速く、安く、上のモデルと変わらない正確さでこなす若手」だと分かりました。では会社の何を任せられるのか。研修先でよく見る仕事から10個選びました。時間の数字は「例えば」の仮定で実測ではなく、業種は例です。
| 業種(例) | 作業 | 今まで(例えばの仮定) | Haiku 5.5で |
|---|---|---|---|
| リフォーム・住宅 | 問い合わせメールの仕分けと担当への振り分け | 1件3分、月300件なら15時間 | 全件を自動で8分類し担当へ通知。人は「要注意」だけ見る |
| 不動産 | 内見希望の日時・人数・連絡先の抜き出し | 1件2分の転記と日付の読み替え | JSONで抜き出して台帳に自動入力。「来週の火曜」も日付に直す |
| 製造 | 日報・点検記録の要約と異常の拾い上げ | 毎朝30分の読み合わせ | 前日分を要約し、「要確認」の行だけ人が見る |
| 運輸・物流 | 配送依頼メールからの住所・時間帯・個数の抜き出し | 1件ごとの手入力 | 抜き出して配車表に流し込む |
| 医療・介護 | 予約変更・キャンセルの連絡文の仕分け | 受付が都度判断 | 変更・キャンセル・新規に仕分けて担当へ(個人情報の扱いは規約の確認が前提) |
| 士業・コンサルティング | 長い議事録や契約書から特定の事項を探す | 1件30分の読み返し | 資料を丸ごと渡して質問。数える質問は考える設定で |
| 小売・サービス | 口コミ・アンケートの自由回答の分類と要約 | 月500件を手作業で分類 | 良い点・不満点・要望に自動分類し、要約を週1で受け取る |
| 全業種 | 社内の規程集・FAQへの質問応答 | 担当者に聞いて待つ | 規程集を前置きにして回答。前置きの使い回しで安く |
| 全業種 | お詫び・案内・求人文の下書き | 1通15分 | 下書きを数秒で。本文だけを出す指示にし、人が確認して送る |
| 全業種(開発者がいる場合) | ウェブの定型作業(フォーム入力、情報の移し替え) | 人がブラウザで手作業 | ブラウザ操作の道具(API・ベータ)に任せる |
最初に試すなら上から1番目か2番目です。正解・不正解がはっきりしていて効果を測りやすく、社内テストで全設定が実用水準だった型の仕事で、全件通しても月に数円から数十円の桁で済むからです。後回しでよいのは10番目で、ブラウザ操作は開発者向けのベータ機能のうえ、公式も「ページの内容は信用できない入力として扱う」よう注意しています。
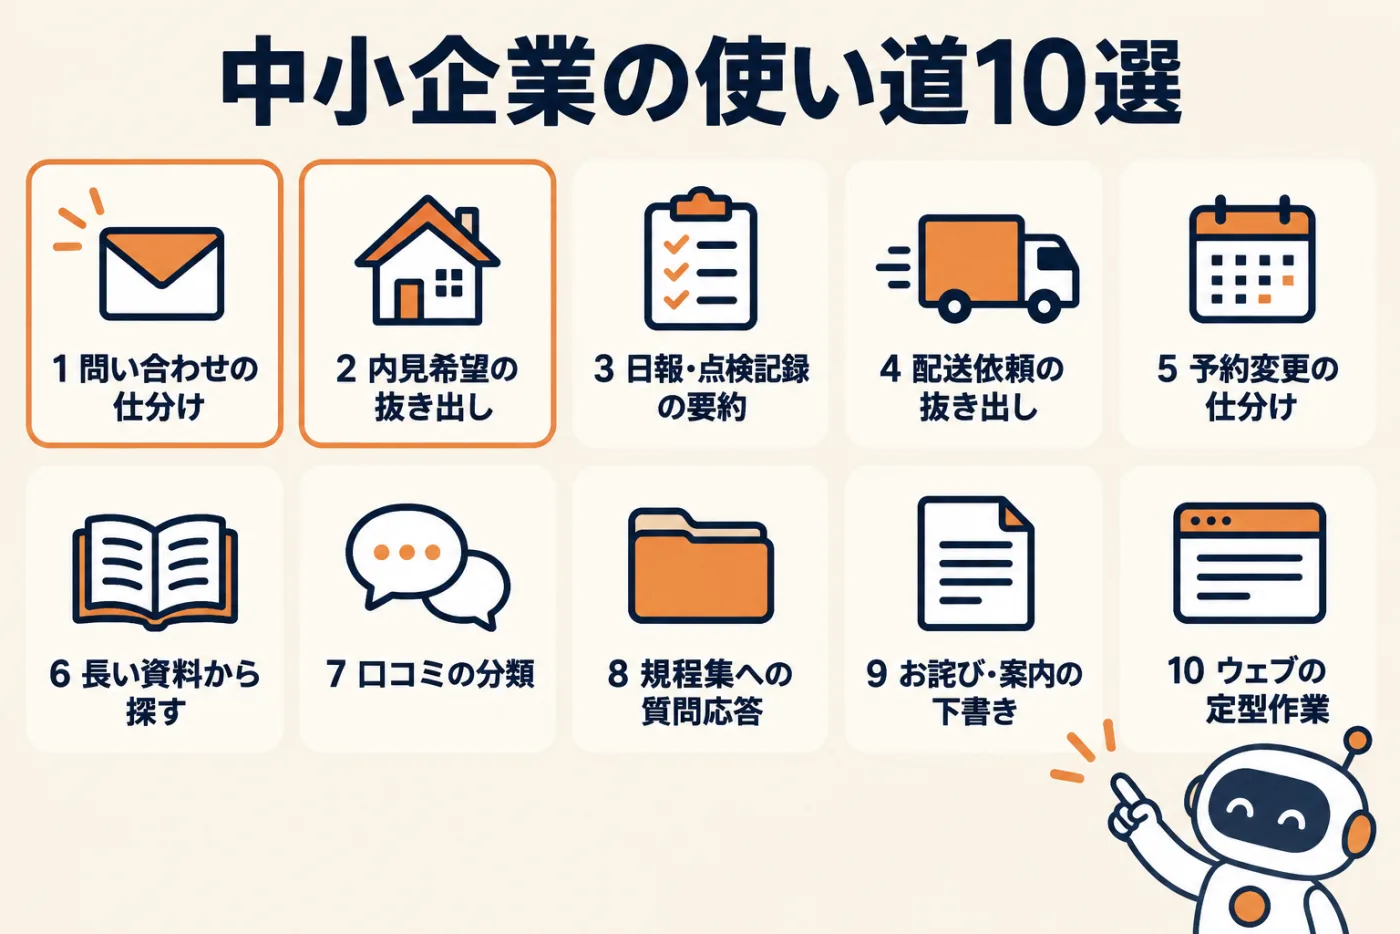
この図は10個の使い道を一覧にしたものです。自社の仕事に近いものを1つ選んで、次の章へ進んでください。
何がどう変わるか——「AIを1回使う」から「仕組みに組み込んで何千回も回す」へ
ここが、この記事でいちばん伝えたいところです。Haiku 5.5で変わるのはAIの賢さの上限ではなく、「AIに任せる仕事の選び方」です。今までのAIの使い方は、基本的には人がアプリを開き、文章を貼り、答えをもらう「1回使う」でした。これでは、どれだけ安くなっても人がアプリを開く手間は減りません。Haiku 5.5が変えるのは、その先の「仕組みに組み込んで、人が触らずに何千回も回す」使い方の採算です。費用の桁を、仕分けの仕事で見てみます。
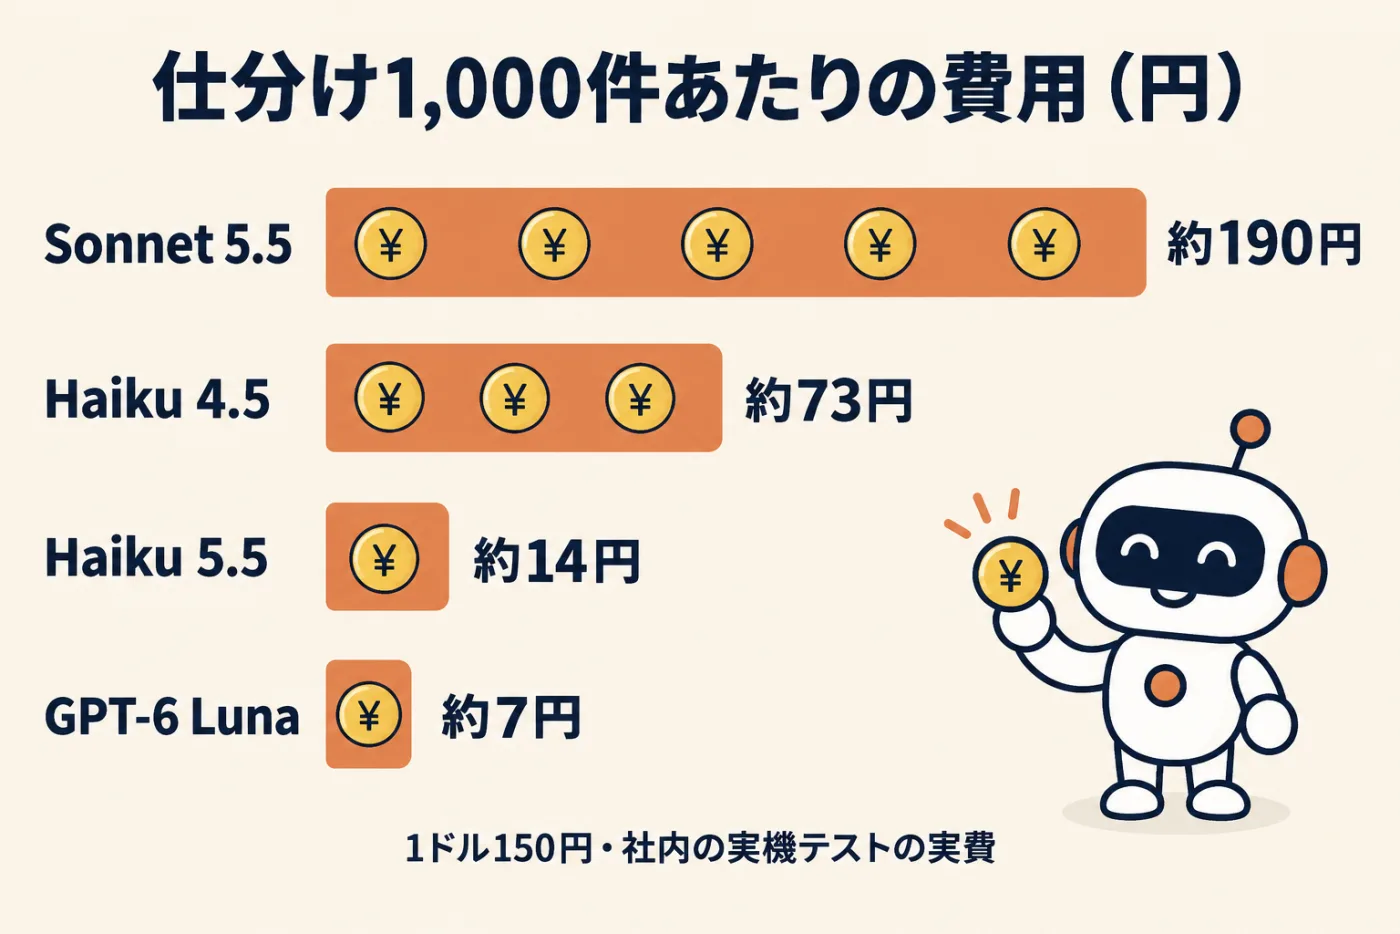
この図は、同じ仕分けの仕事にかかった実費をモデルごとに並べたものです。Haiku 5.5とGPT-6 Lunaの棒は、上の2つと比べると桁が違います。
費用がこの桁になると、判断が変わります。
| 今までの判断 | これからの判断 | 理由 |
|---|---|---|
| 「AIに全件通すのは高い」 | 「全件通して、人は例外だけ見る」 | 1,000件の仕分けが十数円なら、通さない理由がない |
| 「安いモデルは精度が不安」 | 「定型の仕事なら、まず自社の文書で測る」 | 仕分けと抜き出しで、上のモデルと正解の数が変わらなかった |
| 「長い資料は人が要約してからAIに」 | 「10万字までなら丸ごと渡して質問する」 | 8万字の議事録を1回約1.2円で読み、探す質問は全問正解 |
| 「文章は人が一から書く」 | 「下書きは若手、仕上げは人」 | お詫びメールは指示どおりで、余計な約束を足さなかった |
「安いモデルは精度が不安」と考えて、仕分けのような仕事にも上のモデルを使う、というのはよくある判断です。今回のテストでは、定型の仕事なら差が出ませんでした。
仕組みに組み込む形は3つあります。一点目は問い合わせの自動仕分けで、メールやフォームの内容をAPIで送り、分類と理由をJSONで受け取って担当者に通知する形です。二点目は補助役(サブエージェント)で、主役のAI(Opus 5.5やSonnet 5.5)が仕事全体を組み立て、細かい調べ物や下準備をHaiku 5.5に振る形。発表には、開発支援の会社がOpus 5.5を主役、Haiku 5.5を補助役にして、開発テストの点数を保ちながら費用と待ち時間を下げた例があります。三点目はブラウザ操作で、「人が毎日ブラウザでやっている定型作業」が候補に入ります(ベータ機能で、開発者が組む前提)。
もう一つ、ClaudeのMaxプランとTeamプランに毎月のAPI用クレジットが付いたことで、アプリの契約に試作の予算が含まれる形になりました。Max・Teamを契約している会社は、まずはその枠の中で1種類の仕事を回してみてください。
ChatGPTと比べてどうか——アプリとして、部品として
「ChatGPTと比べてどうですか」は、研修でよく出る質問です。先に整理すると、「ChatGPT」はアプリの名前で、中で動くモデルはプランによって違います。2026年10月7日のOpenAIの公式発表によると、ChatGPTのチャットで動くモデルは、Plus・Pro・Business・Enterpriseの有料プランがGPT-6 Sol、無料プランとGoプランがGPT-6 Lunaです(どちらも日常の会話向けに調整)。有料は10月7日から、無料とGoは10月8日から順次の展開なので、10月8日の時点で全員に届いているとは限りません。変わったのはチャットの画面だけで、ChatGPT WorkやCodexは据え置きです。
大事なのは、ChatGPTの無料版の中身であるGPT-6 Lunaが、Haiku 5.5とAPIの単価がまったく同じモデルだということです。なので比較は、①アプリとして(無料同士、有料同士)、②部品として(同じ値段のLunaと)、の2つに分けて見ます。
アプリとして比べる——層をそろえる
| 層 | ChatGPT | Claude |
|---|---|---|
| 無料 | GPT-6 Luna(10月8日から順次) | Haiku 5.5を選べる(既定のモデルかは未確認)。Sonnet 5.5も使える |
| 有料の入口 | Plus 月20ドル。中身はGPT-6 Sol | Pro 月20ドル(年払いなら月17ドル相当)。Sonnet 5.5やOpus 5.5などの上位モデルも選べる |
| 上位 | Pro 月100ドルから | Max 月100ドルから |
| 日本円の表示 | 公式ページで確認できず | 公式の日本語ページもドル表示 |
月額は米ドルで、日本円は各社の申し込み画面で確認してください。無料同士なら、どちらも「同じ値段帯の小型モデルをアプリで使っている」状態で、有料になるとChatGPTは1つ上のSol、ClaudeはSonnet 5.5やOpus 5.5まで選べます。なので、アプリの比較は「無料版の性格の違い」と「有料版で何まで選べるか」の2点で見るのが分かりやすいかなと思います。一つ注意があり、アプリのLunaは会話向けに調整されたもので、APIのLunaと完全に同じ振る舞いとは限りません(OpenAI自身も、本番のChatGPTとは出力が多少異なる場合があると書いています)。この記事の社内テストはAPI経由です。
部品(API)として比べる——同じ値段のGPT-6 Luna
自社の仕組みに組み込む「部品」として見ると、値段は同じでも条件が違います。
| 項目 | Haiku 5.5 | GPT-6 Luna | 意味 |
|---|---|---|---|
| 単価(100万トークン、入力と出力) | 0.10ドルと0.50ドル | 0.10ドルと0.50ドル | 同額 |
| 単価が上がる境目 | 10万トークン超で、その1回が入力も出力も5倍 | 27万2千トークン超で入力2倍、出力1.5倍 | 10万〜27万トークンの資料を一度に渡すならLunaが大幅に安い |
| 一度に読める量 | 100万トークン | 105万トークン | ほぼ同じ |
| 考える強さの段階 | 5段階(APIならhigh以下で考えない設定も可) | 6段階(考えない「none」あり) | どちらも調整できる |
| 日本語の数え方 | 1文字約0.97トークン | 1文字約0.86トークン | 同じ文章をLunaより15〜80%多く数える |
| 同じ資料の使い回し(キャッシュ) | 指定すれば読み取りが10分の1 | 既定で効きやすい(読み取り90%引き) | 社内テストではLunaの2回目以降が自動で約10分の1に |
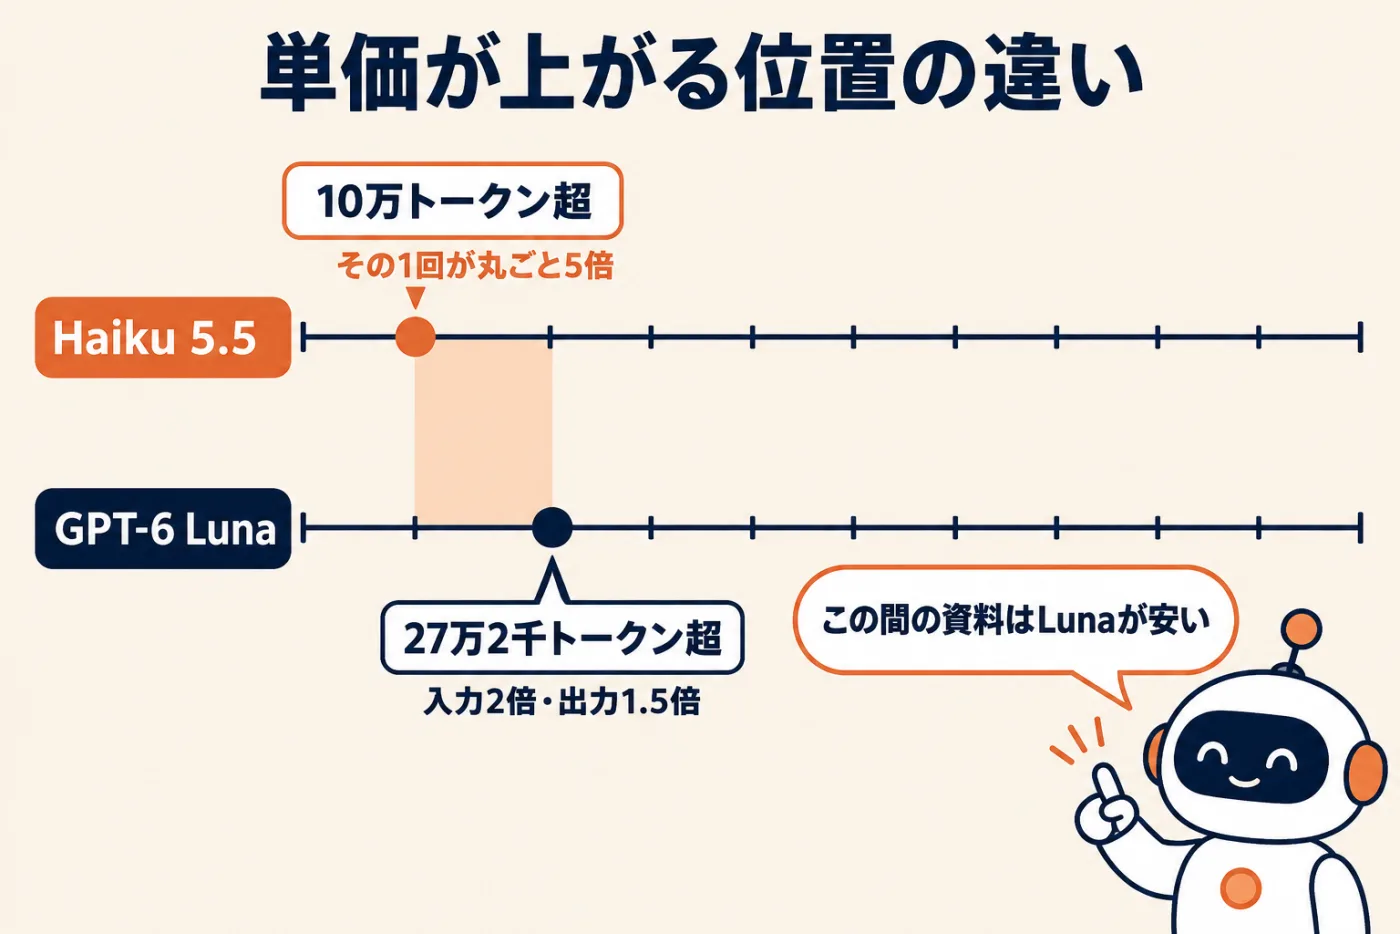
この図は、2つのモデルの「単価が上がる位置」を同じ物差しに置いたものです。資料が長くなるほど、境目の位置の差が効いてきます。
性能はどうか。Anthropicの発表の表では、両者に点数がある項目でHaiku 5.5がLunaを上回っています。ただしAnthropicが選んだテストで、Luna側の数字もOpenAI自身の公表値ではありません。一方のOpenAIは9月22日の発表で、考える強さを最大にしたLunaがコーディングの評価でClaudeの上位モデル(Opus 5・Fable 5のmedium)に匹敵し、1件あたりの費用は93〜96%低いと説明しています。各社が自社に有利なテストと条件を選んで出している、というのが正直な見方です。第三者の独立した測定(Artificial Analysis)では、考える深さ最大同士の総合指標はHaiku 5.5が43、Lunaが38とHaiku 5.5が上ですが、たくさん考えて書く分、1課題あたりの費用は0.21ドル対0.07ドルと高めです(数字は更新で動きます)。
社内テストでは差は小さく、仕事によって得意が分かれました。仕分けは30件中Haiku 5.5が30件、Lunaが29件で、費用はHaiku 5.5が考える分だけ約2倍。文章はLunaが6回とも簡潔でそのまま使え、Haiku 5.5は5回で丁寧め。8万字の議事録は考える設定ならどちらも数える質問まで正解。速さは書き終わるまでがHaiku 5.5の約2.9秒、Lunaは約4.7秒でした。
性格の違いと使い分け表
まとめると、「同じ値段で、性格が違う」です。
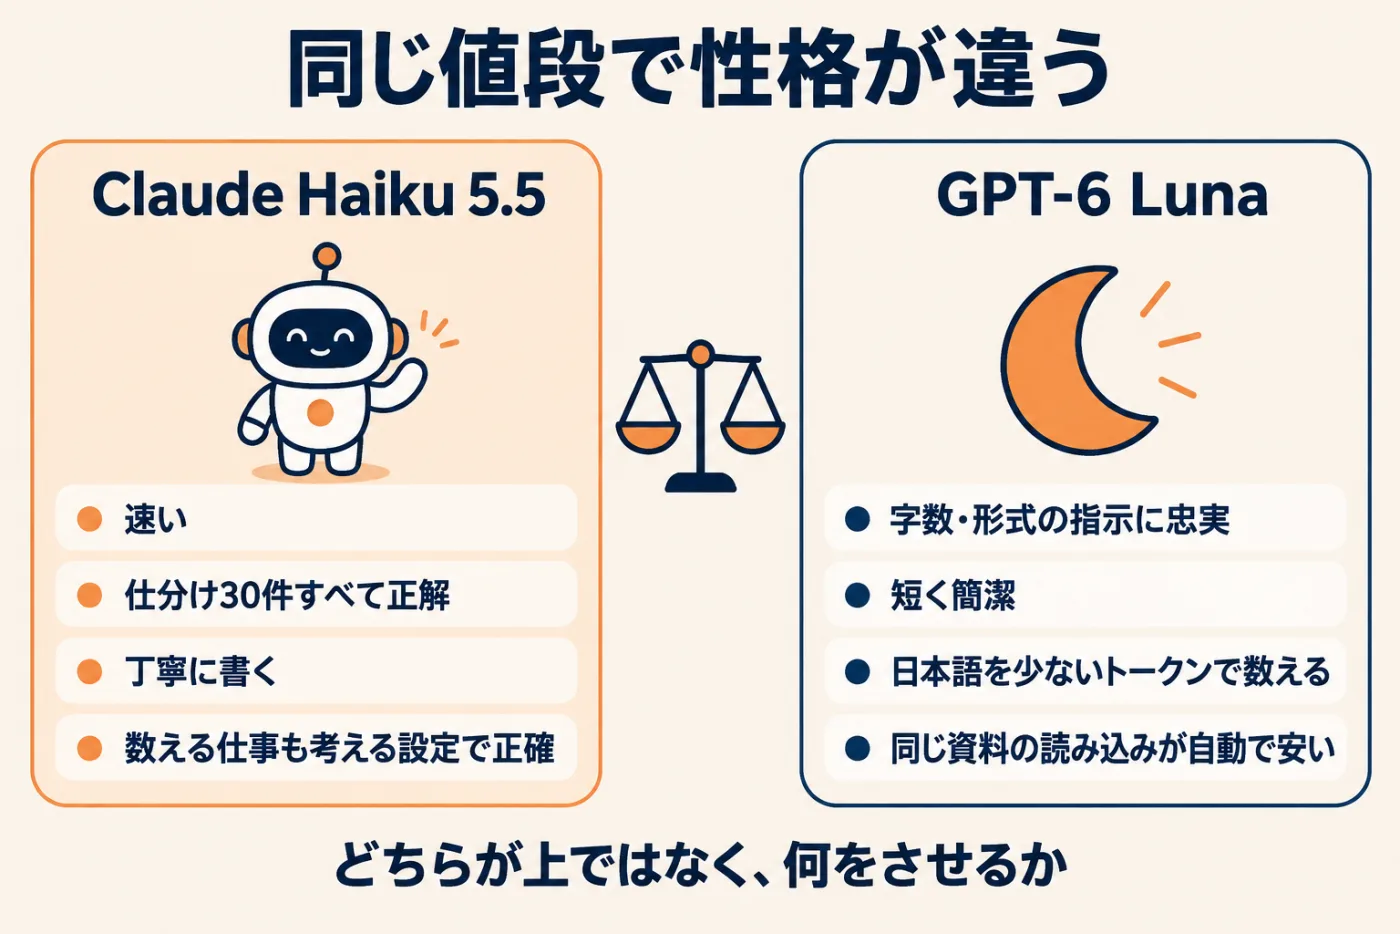
この図は、社内テストで見えた2つのモデルの性格を向かい合わせに並べたものです。どちらかが上、という図ではありません。
| 仕事 | 向くのは | 理由(社内テストと公式情報から) |
|---|---|---|
| 人が待つチャット窓口や電話応対の補助 | Haiku 5.5 | 書き終わるまでが最も短かった |
| 字数・形式を厳密に守る短い定型文 | GPT-6 Luna | 6回とも指示どおりで、最も短く簡潔だった |
| 丁寧な日本語のお詫び・案内文 | どちらも可 | Haiku 5.5は丁寧め、Lunaは簡潔め。文体の好みで選ぶ |
| 長い資料から探す・数える | どちらも可(考える設定で) | 考えない設定は両社とも数え間違えた |
| 10万〜27万トークンの資料を一度に渡す | GPT-6 Luna | 単価が上がる境目が遠い |
| 同じ資料を何度も読ませる | GPT-6 Lunaが手軽 | 自動で使い回しが効いた。Claudeは指定すれば同じ効果 |
| Claudeの上位モデルと組む補助役 | Haiku 5.5 | Opus 5.5が主役、Haiku 5.5が補助役の例が公式に紹介されている |
「どちらが上か」ではなく「何をさせるか」で選ぶ。これが、今回の比較の結論です。
注意点——正直なところ
正直なところ、Haiku 5.5にも落とし穴があります。社内テストで見えたことと、先行して検証した方々の指摘を合わせて、8つにまとめます。
| 注意点 | 何が起きるか | 対策 |
|---|---|---|
| 10万トークンの境目 | 超えた1回は丸ごと5倍。外部ツールの連携(コネクタ)を何個もつなぐと知らないうちに超える。Qiitaの Takuya__ さんは、Claude Codeで1問解かせただけで費用が0.156ドルになり、調べると3回目の依頼が15万トークンに膨らんでいた例を報告(原因はclaude.aiに登録していたコネクタ7個の説明。1問の費用は約90倍に) | 1回に渡す量は日本語で10万字以内。連携は必要な分だけ |
| 考えない設定・低い深さ | 社内テストでは数える質問を数え間違え、前置き・後書きも付いた。Qiitaの kai_kou さんの検証では、深さを最低にすると資料の有無の判定を2回とも誤答 | 数える・判断する仕事は既定のまま。自動送信する文は「本文だけ」と指示 |
| 最大の深さは考えすぎる | noteの れん学長 さんの検証では、短い説明文1本に100秒以上かかった例がある | mediumから始め、上げるのは効果を測ってから |
| 細かく似た分類 | Qiitaの Takuya__ さんの検証では、77分類で既定の設定が60%(Sonnet 5.5は81%) | 分類は10前後に絞り、似たラベルは統合する |
| もっともらしい誤り(ハルシネーション) | 安全性の報告書は、Haiku 4.5と同程度で最近の他モデルより多いと記載。社内テストでも「腕one本」という言葉の誤りが1回あった | 人が最後に読む。根拠の箇所を一緒に出させる |
| 安全のための断り | サイバー関連は厳しめ(ペネトレーションテストなどはブロック)。自動の監査では過剰な断りが試した中で最多との記載もある | 断られたら書き方を変える。セキュリティ研修の題材には注意 |
| 英語・プログラムはトークンが増える | 社内の実測で英語は1.66倍、プログラムは1.18倍。公式の「約30%増」はこちら側の話 | 英語中心の用途は、自社の文書で数えてから試算する |
| 社外秘の扱い | 入れてよい範囲は、契約プランと各社の規約で決まる | 管理者が規約を確認し、入れてよい情報の線を社内で決める |
開発者向けに一つ。Haiku 4.5向けの既存のプログラムは、一部の指定(温度などの細かい設定)がエラーになるので書き換えが要る場合がありますが、依頼文は変更なしでも概ね良好に動くはずだと公式のガイドに書かれています。そして、この記事の点数や秒数はすべて「その条件での結果」です。公式の表は考える深さを最大にした値、社内テストは小さな回数の測定なので、自社の文書で、自社の仕事で測ってから判断してください。
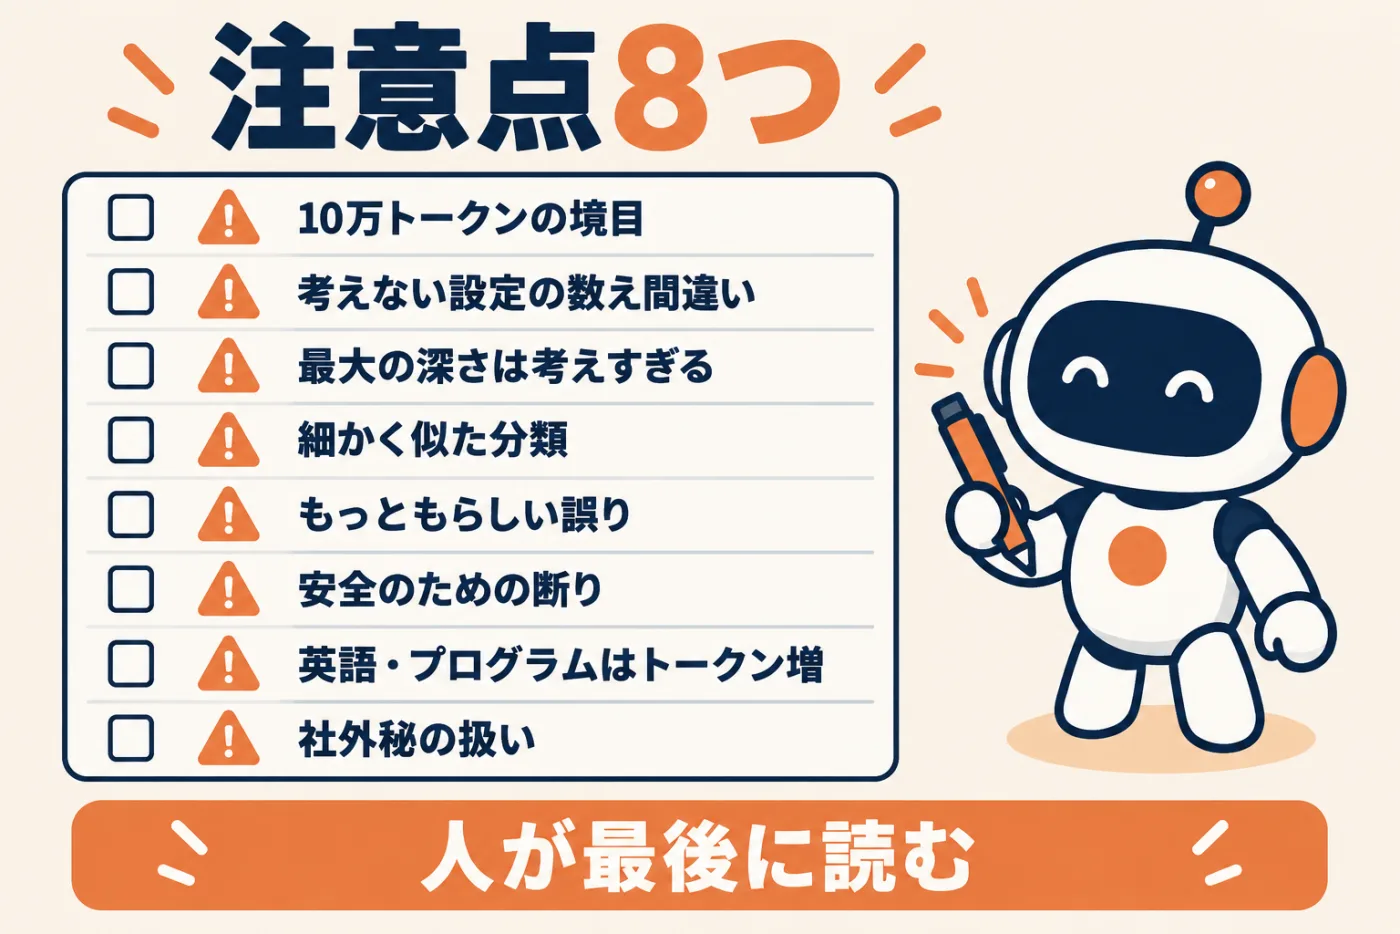
この図は、8つの注意点をチェックリストにしたものです。仕組みに組み込む前に、担当者と一緒に一度なぞってください。
Haiku・Sonnet・Opusの選び方(早見表)
公式の使い分け(Haiku 5.5は速さと量が最優先の仕事、Sonnet 5.5は範囲がはっきり決まった仕事、Opus 5.5は複雑な開発や知識を使う仕事の日常使い)に社内テストの結果を重ねると、早見表は次のようになります(◎はまず試したい、○は使える、△は条件つき)。
| 仕事 | Haiku 5.5 | Sonnet 5.5 | Opus 5.5 |
|---|---|---|---|
| 仕分け・抜き出し・要約(量が多い) | ◎ まずこれ | ○ 単価は20倍 | △ 単価は40倍 |
| 定型の文章の下書き | ◎ | ○ | ○ |
| 長い資料から探す(日本語で10万字以内) | ◎ | ○ | ○ |
| 10万字を超える資料を一度に渡す | △ 単価が5倍 | ◎ 境目がない | ○ |
| 判断が難しい分類・込み入った文章 | ○ 測ってから | ◎ | ◎ |
| 複雑な開発・調査・提案書 | △ 公式も上位を推奨 | ◎ | ◎ |
| 上位モデルと組む補助役 | ◎ | ○ | 主役側 |
選び方のコツは一つで、「安いからHaiku」ではなく「この仕事はHaikuで足りるか」で決めることです。足りるかどうかは、次の章の3ステップで測れます。なお、最上位のFable 5.1は、今回の公式の使い分け案内には登場しません。
始め方3ステップ
まず一点目、アプリで試す。Claudeのアプリで送信ボタンの横のモデル名を押し、Haiku 5.5を選びます。無料プランでも選べ、考える深さも同じメニューにあります。最初は社外秘でない文で、仕分け、抜き出し、お詫びの下書きのどれか1つを頼んでみてください。次の章の依頼文をそのまま貼れます。
二点目、小さく仕組みに組み込む。APIでのモデルの指定はclaude-haiku-5-5です。仕事は1種類(たとえば問い合わせの仕分け)から始め、答えはJSONで受け取り、人が結果を見る形にします。MaxプランやTeamプランなら毎月のAPI用クレジットの枠で試作でき、Claude Codeなら/modelで切り替えられます(バージョン2.1.293以降)。Haiku 4.5向けの依頼文は概ねそのまま動きます。
三点目、測ってから広げる。同じ仕事を3件以上流し、正解の数、人が手直しに使った分数、かかった時間、費用の4つを数えます。あわせて、1回の依頼が10万トークンを超えていないか、考える設定の有無で結果が変わるかも見てください。差が出なければ安い設定で、間違いが出れば深さを上げるか上のモデルへ。逆を返せば、この測り方さえ作っておけば、次に新しいモデルが出ても同じ手順で判断できます。
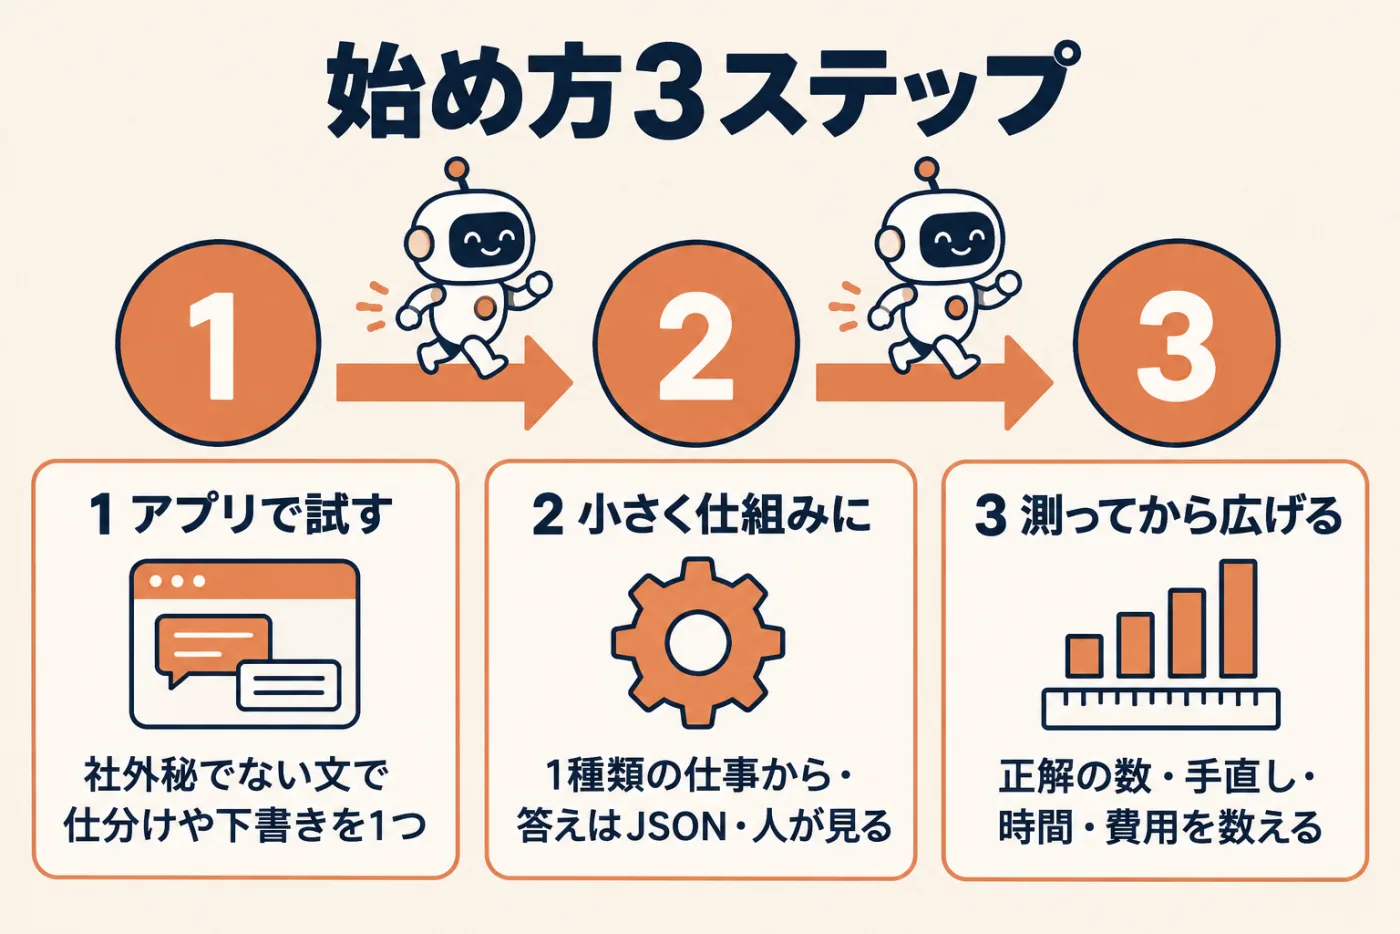
この図は3ステップの流れです。最初の一歩は、アプリに依頼文を貼るだけで踏めます。
そのまま使える依頼文(プロンプト)3つ
社内テストで使った依頼文を、業種を問わず使える形に直しました。角括弧の中を自社の内容に置き換えて、そのまま貼ってください。
依頼文1(問い合わせの仕分け) あなたは[会社名]の受付担当です。次の問い合わせ文を、見積依頼、日程変更・キャンセル、苦情・不具合、請求・支払い、採用、営業・売り込み、要注意(詐欺の疑い)、その他、の8つのどれか1つに分類してください。振込先の変更、至急の送金依頼、パスワードの再設定を求める文は「要注意」にしてください。出力はJSONだけで、{“分類”: ”…”, “理由”: ”…”} の形にし、理由は30字以内。前置きや説明文は付けないでください。 問い合わせ文:[ここに貼る]
依頼文2(問い合わせ文からの情報の抜き出し) 今日は[2026年10月8日(木)]です。次の文から、会社名、担当者の名字、希望日(西暦の年月日に直す)、人数、電話番号、予算の合計(円の数字)を抜き出し、JSONだけで返してください。書かれていない項目は null にしてください。「来週の火曜」のような日付は今日を基準に計算し、「(株)」は「株式会社」に直してください。 文:[ここに貼る]
依頼文3(お詫びメールの下書き) [会社名]の[差出人名]として、[宛先の名前]様へのお詫びメールを書いてください。理由は[資材の入荷遅れ]、新しい開始日は[10月20日]です。件名を含めて300字以内、絵文字なし、頼んでいない事実や約束は足さないでください。本文だけを出力し、前置き・後書き・記号は付けないでください。
長い資料に数える質問をするときは、考える深さを既定のままにしてください。社内テストでは、考えない設定が数え間違えています。
よくある質問
無料で使えますか
Claudeのアプリでは無料プランを含む全プランでHaiku 5.5を選べる、とAnthropicの製品ページに書かれています。ただし、無料プランの既定のモデルがHaiku 5.5かどうかと、無料で使える回数の上限は、公式ページで確認できていません。画面のモデル一覧で確かめてください。
ChatGPTから乗り換えるべきですか
乗り換えの話ではないかなと思います。ChatGPTの無料版の中身はGPT-6 Lunaで、Haiku 5.5と同じ値段帯のモデルです。速さと丁寧さが要る仕事はHaiku 5.5、短く形式どおりの文はLuna、と仕事で使い分けるのが現実的です。
Sonnet 5.5とどちらを使うべきですか
範囲のはっきりした仕事(仕分け、抜き出し、要約、定型文の下書き、長い資料から探す)はHaiku 5.5から。判断が難しい分類、込み入った文章、複雑な開発はSonnet 5.5です。迷ったら3件流して測ってください。
日本語は大丈夫ですか
公式には日本語だけの性能の数字はありません。42言語の知識テストの平均は87.8%で、Sonnet 5.5の92.1%より低い水準です。社内テストでは、熊本弁、和暦、漢数字、「再来週の金曜」のような日付の計算を正しく処理しました。一方で「腕one本」と英単語が混ざった例もあったので、人が読む前提は外さないでください。
社外秘の情報を入れてもいいですか
入れてよい範囲は、契約しているプランと各社の規約で決まります。会社で使う前に管理者が規約を確認し、「入れてよい情報」「入れない情報」の線を社内で決めてください。最初の練習は、公開済みの文章で十分です。
Haiku 4.5はいつまで使えますか
今も使えますが旧モデル(レガシー)の扱いで、Haiku 5.5への移行が推奨されています。公式の表では提供終了は「2026年10月15日より前にはしない」とされていて、終了日が確定したわけではありません。Haiku 5.5は「2027年10月7日より前にはしない」です。
まとめ——「安いからHaiku」ではなく「この仕事はHaikuで足りるか」
最後に3行でまとめます。
- Claude Haiku 5.5は、2026年10月7日(米国時間)に出た「速くて安い若手」です。料金はHaiku 4.5の10分の1(10万トークン以下のとき)、読める量は5倍、考える深さを5段階から選べます
- 社内の実機テストでは、仕分け30件は全問正解、8万字の議事録から探す質問も全問正解、400字の文章は約2.9秒。費用は1,000件の仕分けで約14円、8万字の読み取りで1回約1.2円でした(1ドル150円の仮定、小さな社内テスト)
- ChatGPTの無料版の中身であるGPT-6 Lunaとは同じ値段で性格が違います。注意点は、10万トークンの境目、考えない設定の数え間違い、もっともらしい誤り。人が最後に読む前提は変わりません
AIの賢さの上限を競う話ではなく、「定型の仕事を、安く、速く、何千回も回す」話です。まずは、自社の問い合わせを10件、アプリに貼って仕分けさせるところから始めてみてください。
WizTryでは、熊本を中心に、生成AIを実務で使うための企業研修と、AIエージェントの導入支援を行っています。「どの仕事から任せればよいか」「仕組みに組み込むときの社内ルールをどう決めるか」といった相談は、熊本の生成AI研修やお問い合わせから、お気軽にお寄せください。
※本記事は2026年10月8日時点の公式情報と社内の実機テストにもとづきます。料金・仕様・提供範囲は変わることがあります。最新の情報はAnthropicとOpenAIの公式ページでご確認ください。
参考にした情報
一次情報
- Introducing Claude Haiku 5.5(Anthropic発表ページ)
- Claude Haiku 5.5 システムカード(安全性の報告書)
- Claude API 料金表
- GPT-6 and Intelligent UI for everyone(OpenAI、2026年10月7日)
- GPT-6 SolとLunaのご紹介(OpenAI、2026年9月22日)
- GPT-6 Luna モデル仕様(OpenAI)